综合实验:基于 CO2 排放量数据集的数据分析及可视化
9.1 这是什么
这一章做一次完整的综合实验:拿一份全球 CO2 排放量的历史数据,从 HDFS 读进来,用 PySpark 做清洗与聚合,用 Spark MLlib 把多个数值列拼成特征向量并算出相关系数矩阵, 最后用 Jupyter Notebook 加 matplotlib、seaborn、geopandas 把结果画成柱状图、折线图、 相关性热力图和世界地图。产出是一组落在 HDFS 上的分析结果目录,以及一组可直接放进 报告的统计图。
CO2 排放量数据集:一份按「国家 + 年份」组织的历史排放统计表,每个国家每一年是一行, 列上分列了总排放量以及煤、石油、天然气、水泥、放空燃烧等分项排放量,还有一个人均 排放量列。它天然适合做分组聚合和时间序列趋势分析,所以被用作综合实验的样本数据。
PySpark:Spark 的 Python 接口。Spark 是基于内存的分布式计算引擎,把数据分片后并行 处理;相比 MapReduce 少了反复落盘,迭代计算快得多。PySpark 让 Python 代码去驱动这批 分布式算子,DataFrame 是它最主要的数据抽象。
CSV 与 DataFrame 的 schema:CSV 是纯文本的逗号分隔表格,读进来时没有类型信息;schema 描述的就是这份表格每一列叫什么、是什么类型、能不能为空。用 inferSchema=True 让 Spark 抽样推断类型,printSchema() 把结果打印出来核对。
MLlib:Spark 自带的机器学习库,提供特征处理、统计、回归、聚类、协同过滤等算法。 本实验用到的是其中的特征转换器和统计工具。
VectorAssembler:MLlib 的特征转换器,把多列数值拼成一个特征向量。Spark 的机器学习 算法不逐列接收输入,只接收一列向量,所以要先做这一步拼接。
Correlation:MLlib 的统计工具,对特征向量逐对计算相关系数。相关系数取值在 -1 到 1 之间,绝对值越接近 1 说明两列的线性关系越强,接近 0 说明基本没有线性关系。
matplotlib:Python 最基础的绘图库,柱状图、折线图、散点图都由它出图。
seaborn:构建在 matplotlib 之上的统计绘图库,风格统一,画热力图和分布图比 matplotlib 本身省事。
geopandas:处理地理数据的 Python 库,可以在世界地图底图上按国家填色。本实验用它的 内置数据集 naturalearth_lowres 作为离线底图,不需要联网下载。
热力图的 annot 参数:控制是否在每个格子里把数值标出来。相关系数矩阵只有把数字标出 来才能逐格读数,所以绘图时把它设为 True。
在整体流程里处在哪一步:这是全书最后一个综合实验,前面八章分别把平台搭好(第 1 章 的 Hadoop/HDFS/Spark/PySpark 环境)、用 Spark SQL 处理结构化数据(第 3 章)、用 MLlib 跑算法(第 5 章)、用网页把结果展示出去(第 6 至 8 章)。这一章不再引入新平台,而是把 已装好的平台、SQL 式聚合、MLlib 统计能力和图表展示能力合起来用一遍,验证整条链路是 不是通的。
9.2 前置条件
开始动手前,下面这些必须已经具备,逐条核对:
- Hadoop 已经启动,
jps输出里能看到NameNode、DataNode,以及单机模式下的
SecondaryNameNode。
- Spark 已经安装并配好环境变量,
spark-submit --version能打印版本号。 - PySpark 能在 Python 里直接导入,
python -c "import pyspark; print(pyspark.__version__)"
有输出。
- Anaconda 与 Jupyter Notebook 已安装,
jupyter notebook --version有输出。 - Python 环境里已经装好
pandas、matplotlib、seaborn、geopandas,导入不报错。 - 数据文件
dataset.csv已经上传到 HDFS,用
hdfs dfs -ls /user/xmw/dataset.csv 能看到该文件。
- HDFS 上已经存在实验用的输出目录前缀
/co2/,写盘时由程序自动创建也可以。 - 前置知识:会写基本的 PySpark
DataFrame聚合;看得懂相关系数的含义;知道 Jupyter
Notebook 是按单元格执行的。
9.3 操作步骤
9.3.1 任务分析与环境搭建
这一步把前面各章装好的组件串起来,并明确本实验要回答的问题。任务是四件事:哪些国家 排放最多、中国近十年的排放走势如何、全球排放的长期趋势是什么、各排放分项之间哪些 相关性高。
先核对平台上该跑的进程都在。
# 执行目录:任意目录,登录 Hadoop 所在的 Linux 机器后直接执行
jps
应当看到类似下面的输出,其中必须有 NameNode 与 DataNode。
31802 NameNode
32045 DataNode
32420 SecondaryNameNode
数据集的列一共十列,含义如下。
| 列名 | 含义 |
|---|---|
Country | 国家或地区名称 |
Year | 年份 |
Total | 该国当年 CO2 排放总量 |
Coal | 煤炭来源的排放量 |
Oil | 石油来源的排放量 |
Gas | 天然气来源的排放量 |
Cement | 水泥生产过程的排放量 |
Flaring | 天然气放空燃烧的排放量 |
Other | 其他来源的排放量 |
PerCapita | 人均排放量 |
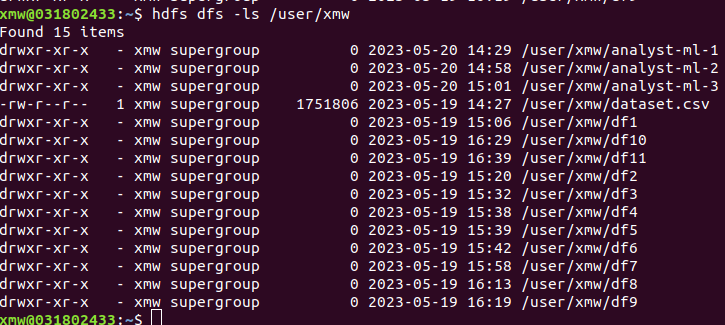
把数据文件放进 HDFS,并确认落位。
# 执行目录:数据文件所在目录(例如 /home/ubuntu18/data)
hdfs dfs -mkdir -p /user/xmw
hdfs dfs -put -f dataset.csv /user/xmw/dataset.csv

# 执行目录:任意目录
hdfs dfs -ls /user/xmw/
-put -f 表示存在同名文件时覆盖,重复上传不会报错。输出里应出现 dataset.csv 一行。
启动交互式的 PySpark,用它逐段验证后续代码。
# 执行目录:任意目录
pyspark --master local[*]
提示符变成 >>> 即进入交互式会话;按 exit() 退出。如果只是想跑脚本, 带 --num-executors 之类的参数用 spark-submit 提交也可以,本实验的数据量小, 用 local[*] 就够。
9.3.2 用 PySpark 做基础数据分析
这一步把 CSV 读成 DataFrame,确认 schema,然后按国家和年份两个维度做聚合。
读文件并查看结构。header=True 表示第一行是列名,inferSchema=True 让 Spark 推断 每列类型。
from pyspark.sql import SparkSession
from pyspark.sql.functions import sum, avg, col

spark = SparkSession.builder.appName("co2-analysis").getOrCreate()

mdf = spark.read.csv("hdfs://localhost:9000/user/xmw/dataset.csv",
                     header=True, inferSchema=True)
mdf.printSchema()
mdf.show(5)
printSchema() 应当把 Country 打印成 string,把 Year、Total、Coal 等打印成 int 或 double。如果全部是 string,说明 inferSchema 没生效,后续求和会得到 拼接结果而不是数值,需要显式 cast。
按国家聚合总排放量并排名。groupBy 分组、agg 聚合、orderBy 排序是 Spark SQL 最 核心的三件套,第 3 章已经反复用过。
country_total = mdf.groupBy("Country") \
    .agg(sum("Total").alias("Total")) \
    .orderBy(col("Total").desc())

country_total.show(10)
前十名的结果按总量从大到小排列,第一行是一个排放量远高于其余国家的经济体。
按年份聚合全球总量,得到长期趋势的底表。
year_total = mdf.groupBy("Year") \
    .agg(sum("Total").alias("Total")) \
    .orderBy("Year")

year_total.show(20)
这一步的产出是两份聚合结果。数据量小的时候停留在驱动端即可;要落盘的话,把 country_total 换成后面 9.3.3 的 write.mode("overwrite") 写法即可。
9.3.3 用 Spark MLlib 做特征处理与相关性分析
这一步把九个数值列拼成一个特征向量,再用 Correlation 算出逐对的相关系数矩阵, 并把矩阵和后续的统计摘要写回 HDFS。
先做向量化。VectorAssembler 的三个关键参数是 inputCols(要拼哪些列)、outputCol (拼完叫什么)、handleInvalid(遇到空值怎么办,skip 表示丢弃该行而不是报错)。
from pyspark.ml.feature import VectorAssembler
from pyspark.ml.stat import Correlation
import pandas as pd

input_cols = ["Year", "Total", "Coal", "Oil", "Gas",
              "Cement", "Flaring", "Other", "PerCapita"]

assembler = VectorAssembler(
    inputCols=input_cols,
    outputCol="features",
    handleInvalid="skip"
)
df_vector = assembler.transform(mdf)
df_vector = df_vector.select("features")
assembler.transform 是惰性转换,执行 show 或 count 时才真正触发计算。接着算相关 系数,Correlation.corr 返回的是一个只有一行一列的 DataFrame,取出该行第一个字段再 转成 NumPy 数组。
corr_result = Correlation.corr(df_vector, "features").head()
corr_matrix = corr_result[0].toArray()
打印出来的矩阵是一个九行九列的对称矩阵,对角线全是 1。矩阵中可以直接读到的几个值: Total 与 Coal 为 0.92252468,Total 与 Oil 为 0.88155979,Total 与 Gas 为 0.76765279,Total 与 Cement 为 0.75648464,Total 与 Other 为 0.79028342, Total 与 Flaring 为 0.39029784,Total 与 PerCapita 为 0.07027924。分项之间, Coal 与 Cement 为 0.8915956,Coal 与 Other 为 0.8889763,Cement 与 Other 为 0.90823967,Oil 与 Gas 为 0.89997838。
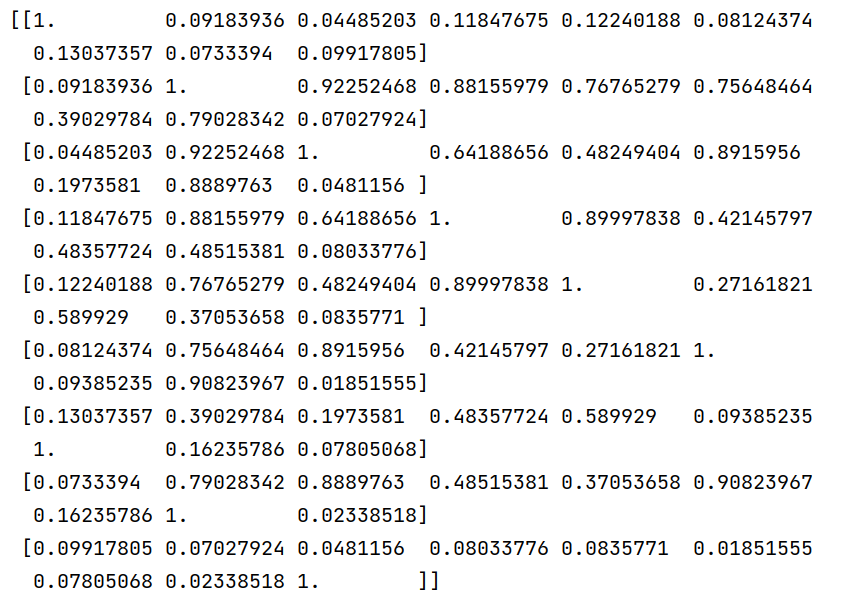
由于 Spark 的 to_csv 写法在集群模式下容易踩序列化的坑,这里采用「转到 Pandas 落 本地临时文件,再用 Spark 读回来写 HDFS」的两段式写法,本机跑稳定。
corr_pd = pd.DataFrame(corr_matrix)
corr_pd.to_csv("file:///home/ubuntu18/corr_temp.csv", index=False, header=False)

result = spark.read.csv("file:///home/ubuntu18/corr_temp.csv",
                        header=False, inferSchema=True)
result.write.mode("overwrite").csv("/co2/analyst-ml-1")
result.show()
file:/// 前缀表示本地文件系统而不是 HDFS,少了这个前缀 Spark 会去 HDFS 上找路径。 write.mode("overwrite") 保证重复执行不会因为目录已存在而失败。
接着做线性回归预测下一年的排放量,把预测结果写成 DataFrame 落盘。预测值是一个标量 Python 浮点数,需要用 createDataFrame 转回分布式表才能写 HDFS。
result_df = spark.createDataFrame(
    [("China", 2023, predicted_total)],
    ["Country", "Year", "PredictedTotal"]
)
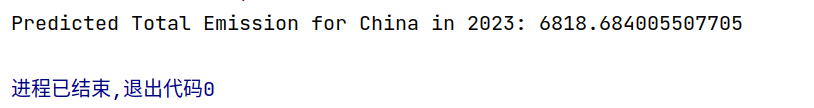
result_df.write.mode("overwrite").format("csv").save("/co2/analyst-ml-2")运行结束后终端打印的预测值与退出码如下,进程已结束,退出代码0 表示脚本正常收尾。
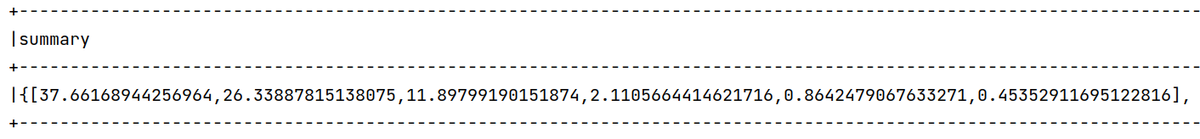
最后用 MLlib 的汇总统计拿到各列的均值、方差等信息,结果存成 Parquet。Parquet 是列式 存储格式,适合后续按列读取。
from pyspark.ml.stat import Summarizer

summary_df = df_vector.agg(
    Summarizer.summary(df_vector.features).alias("summary")
)

summary_df.show(truncate=False)
summary_df.write.parquet("/co2/analyst-ml-3")
truncate=False 让整行完整打印,不被省略号截断。输出形如一行数组,元素依次对应各列 的统计量。
9.3.4 用 Jupyter + matplotlib/geopandas 做可视化
这一步换到 Jupyter Notebook 里,把聚合结果转成 Pandas 再用绘图库出图。启动方式:
# 执行目录:任意目录,目录下若有 .ipynb 会一并出现在列表里
jupyter notebook --ip=0.0.0.0 --port=8888 --allow-root
浏览器打开终端里打印的地址,新建一个 Notebook。每个单元格里都先建立 Spark 会话并 把数据读成 mdf,再 toPandas() 转本地表——绘图库只认 Pandas,不认 Spark DataFrame。
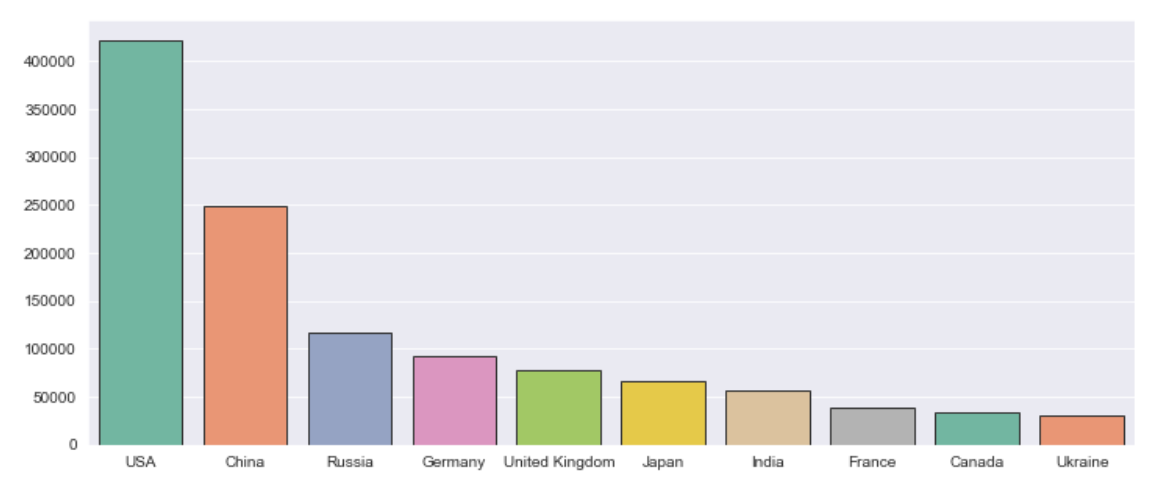
排放总量前 10 的国家用柱状图表示。sort_values 按总量降序,取前十个国家名和值。
import matplotlib.pyplot as plt
import seaborn as sns

countries = list(df.groupby('Country').sum().sort_values(by='Total', ascending=False).index)
values = list(df.groupby('Country').sum().sort_values(by='Total', ascending=False)['Total'])

plt.figure(figsize=(12, 5))
sns.set_style('darkgrid')
sns.barplot(x=countries[:10], y=values[:10], palette='Set2', edgecolor='.2')
figsize 控制画布尺寸,单位是英寸;edgecolor 给柱子加描边。出图后前十名的顺序与 9.3.2 里的排名一致。
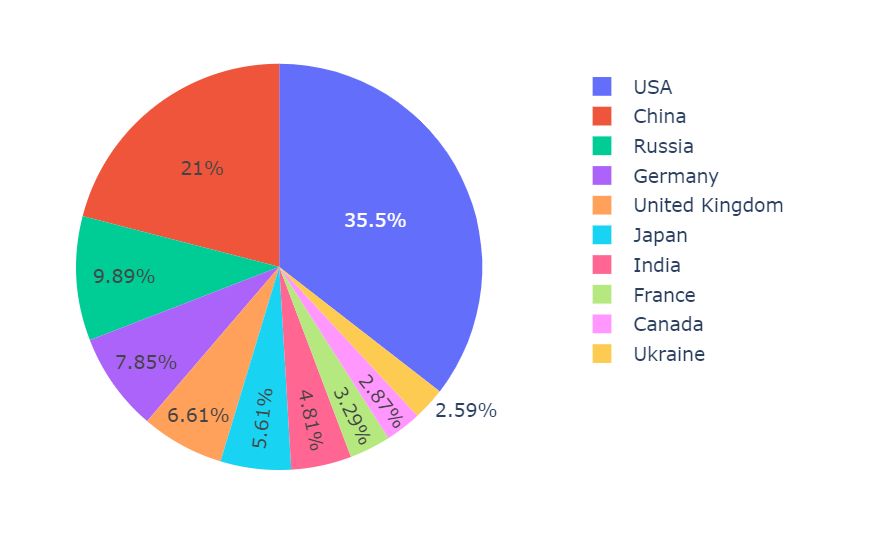
同一批数据用饼图看占比。图例在右侧列出十个国家,扇区上标的是各自百分比。
中国 2012 到 2021 年的排放量单独拎出来看,左边折线看走势、右边柱状看逐年数值。
china = mdf.filter((mdf.Year >= 2012) & (mdf.Year <= 2021)) \
    .groupBy("Year").agg(sum("Total").alias("Total")) \
    .orderBy("Year").toPandas()

plt.figure(figsize=(12, 5))
plt.plot(china["Year"], china["Total"])
plt.xlabel("Year")
plt.ylabel("Total")
plt.title("China CO2 Emissions Line Chart")
plt.show()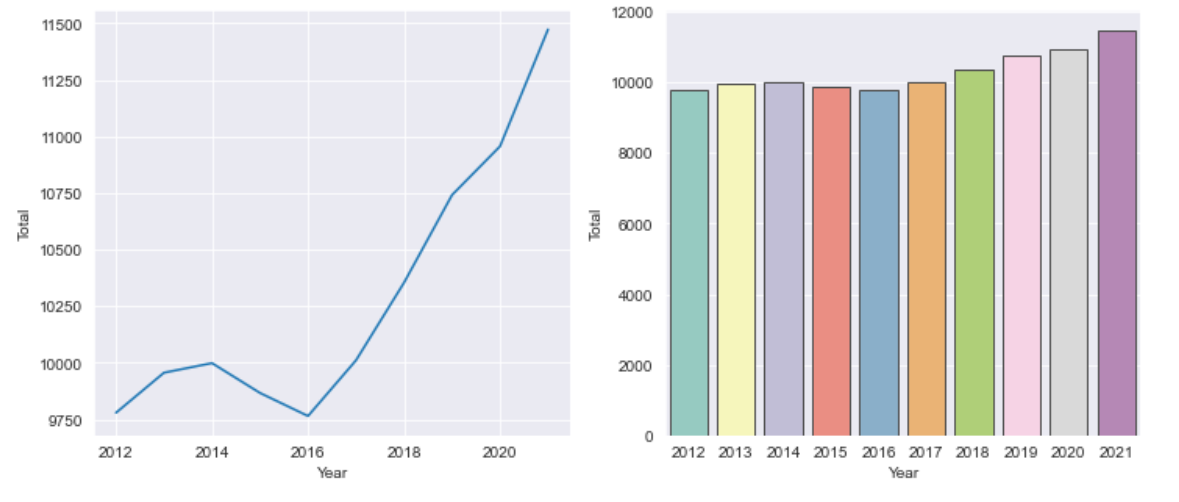
全球各类排放的年度趋势用多条折线叠加。按年份分组后对每一类分别求和,toPandas() 一次带回本地。
from pyspark.sql.functions import sum
import matplotlib.pyplot as plt

categories = ['Coal', 'Oil', 'Gas', 'Cement', 'Flaring', 'Other']

global_trend = mdf.groupBy("Year") \
    .agg(sum("Coal").alias("Coal"),
         sum("Oil").alias("Oil"),
         sum("Gas").alias("Gas"),
         sum("Cement").alias("Cement"),
         sum("Flaring").alias("Flaring"),
         sum("Other").alias("Other")) \
    .orderBy("Year") \
    .toPandas()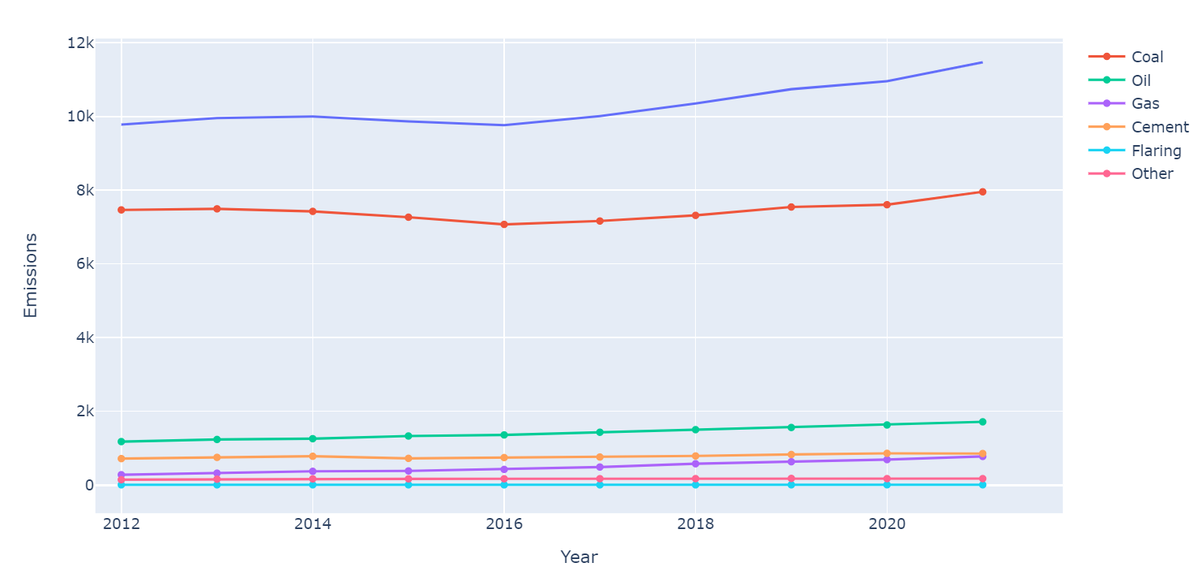
相关性热力图直接用 9.3.3 算出的系数矩阵绘制,annot=True 把数值写进每一格,配色深浅 再看绝对值大小。
import seaborn as sns
import matplotlib.pyplot as plt

plt.figure(figsize=(10, 8))
sns.heatmap(corr_matrix, annot=True, cmap='YlGnBu',
            xticklabels=input_cols, yticklabels=input_cols)
plt.show()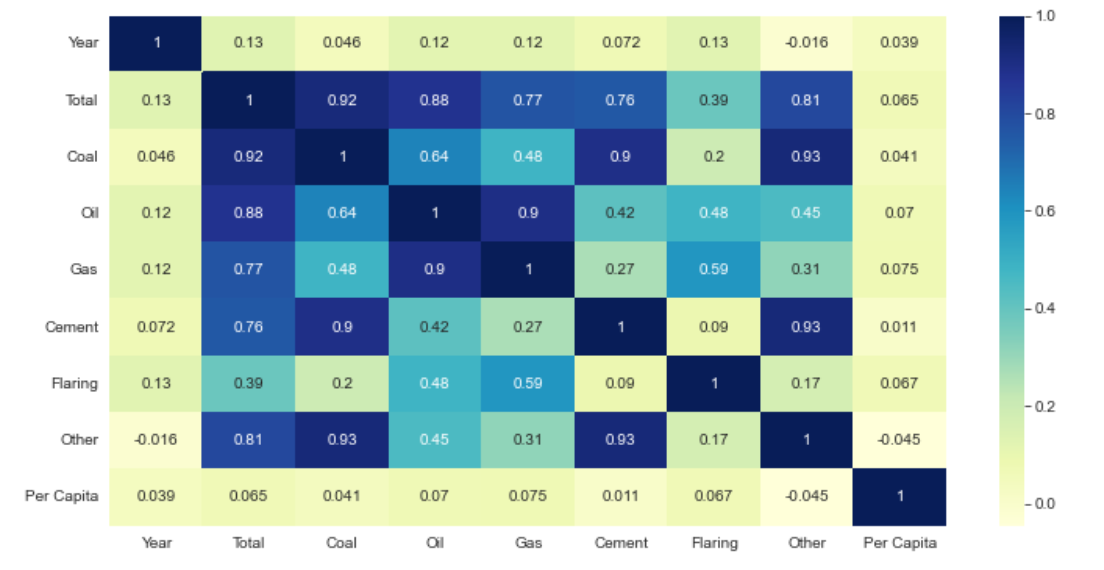
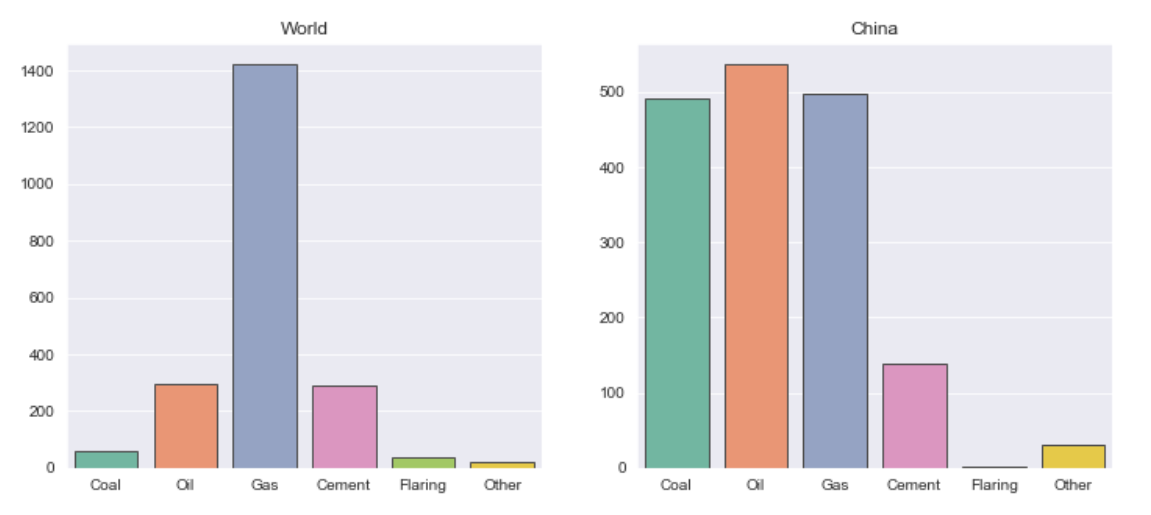
世界范围与中国范围内分项排放的对比放在并排的两张柱状图里,左边是全球各类合计、 右边是中国各类合计,可以看出两者都以煤、油、气为主。
人均排放用均值而不是求和,因为人均列本身已经是比值,再求和没有意义。
from pyspark.sql.functions import avg
import matplotlib.pyplot as plt

year_df = mdf.groupBy("Year") \
    .agg(avg("PerCapita").alias("PerCapita"),
         avg("Total").alias("Total")) \
    .orderBy("Year") \
    .toPandas()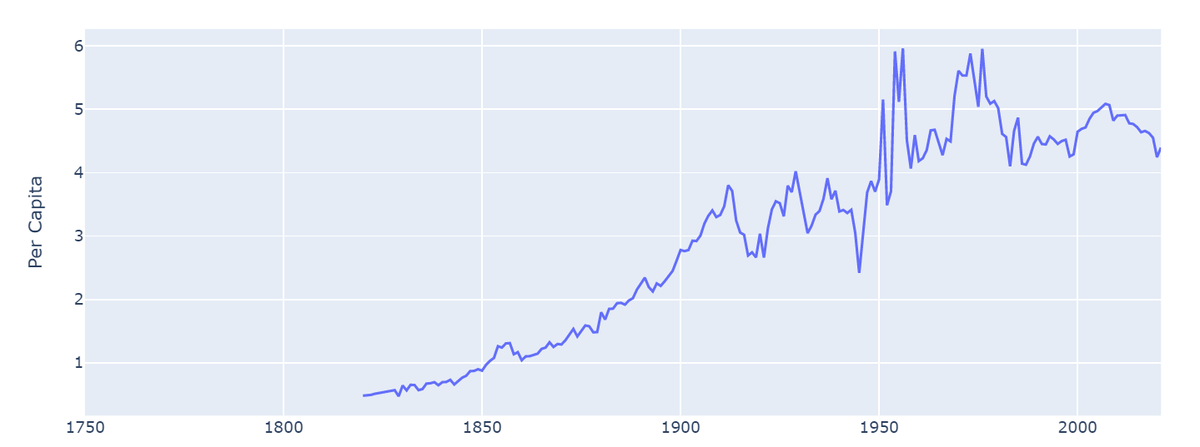
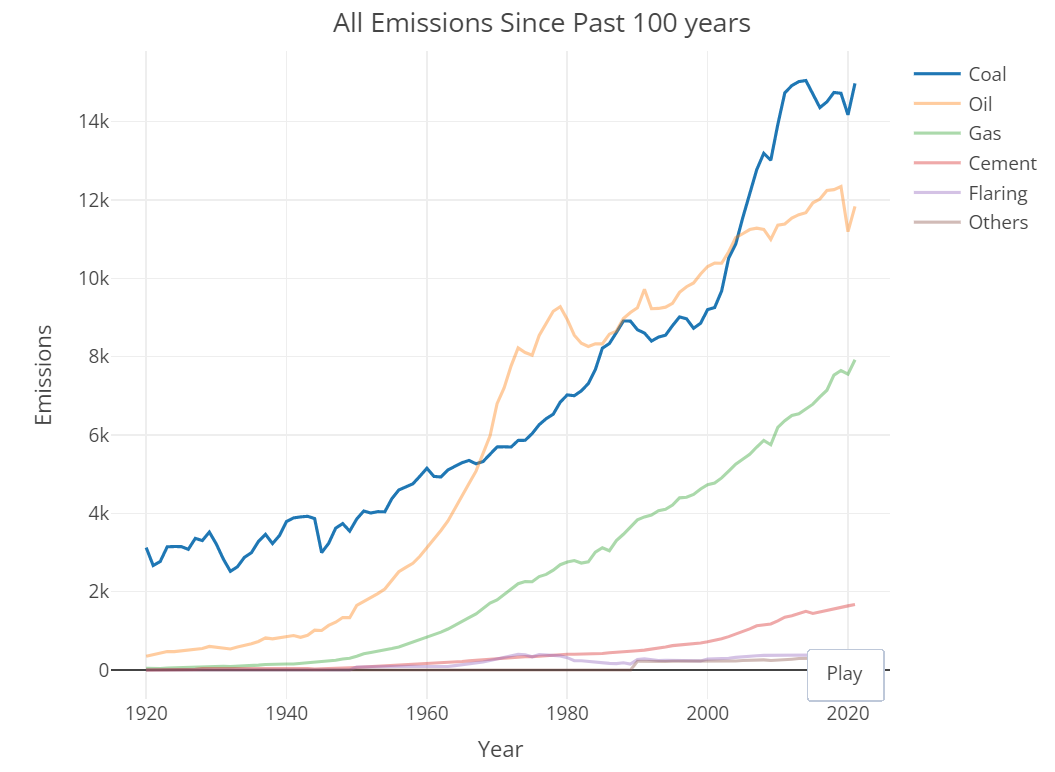
把时间窗口拉长到近一百年,各类排放的长期走势更清楚,煤炭在二十世纪中期之后快速 抬升并超过石油。
再画一张散点图看总量与人均两个指标的关系,横轴总量、纵轴人均,不同国家用不同颜色, 图例标出国家名。
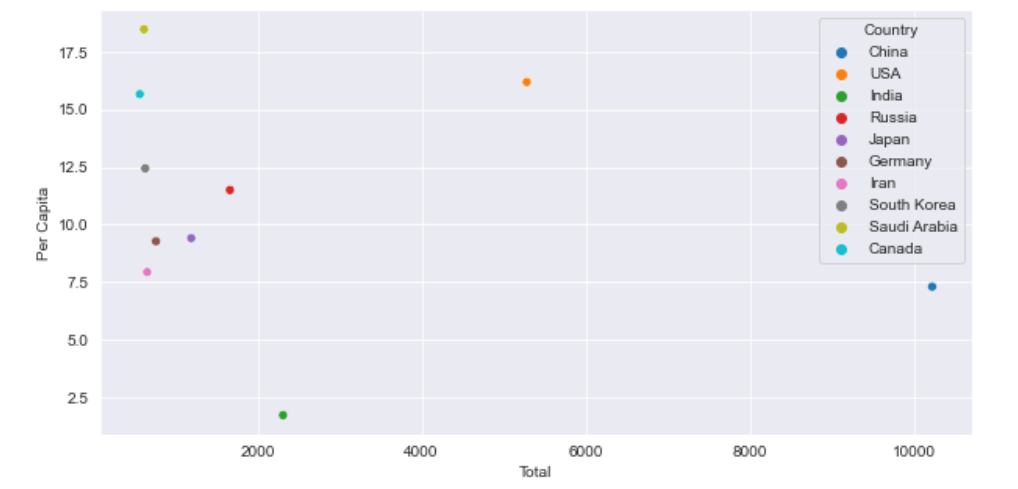
世界地图用 geopandas 的离线底图按国家填色,naturalearth_lowres 是它自带的世界边界 数据集,无需联网。
import geopandas as gpd
import matplotlib.pyplot as plt

world = gpd.read_file(gpd.datasets.get_path('naturalearth_lowres'))
world.rename(columns={"name": "Country"}, inplace=True)

columns = ['Coal', 'Oil', 'Gas', 'Cement', 'Flaring', 'Other']
底图数据集里的国家名列叫 name,与本数据集里的 Country 不一致,必须先 rename 才能按国家名合并,这是地图部分最容易卡住的一步。地图效果的输出本实验从略, 只保留代码与底图准备步骤。
9.3.5 汇总结论
把前面几步的图表结论归拢,回答 9.3.1 提出的四个问题。
排放最多的国家:总量排名前十依次是美国、中国、俄罗斯、德国、英国、日本、印度、法国、 加拿大、乌克兰。美国一家占到前十名合计的约 35.5%,中国约占 21%,两国合计超过一半。 排放量与国家的工业化程度、经济规模直接相关,排放量最高的几个都是经济大国。
中国 2012 至 2021 年的趋势:这十年间从约 9800 一路升到约 11500,中间 2015 到 2016 年 有一次回落,2016 年触底后逐年抬升,2019 年之后增速明显加快。用线性回归外推, 2023 年的总量预测值约为 6818.68。
全球排放趋势:近百年全球 CO2 排放持续增长,近几年增速还在加快。从 2012 到 2021 的 分项看,天然气排放一路上行,煤炭在 2015 至 2016 年小幅回落后又重新走高,石油保持 平稳,其余各项变化不大。
相关性强的物质:Total 与 Coal 的相关系数为 0.92、与 Oil 为 0.88、与 Gas 为 0.77、 与 Cement 为 0.76,说明总排放量由这几项共同决定,其中煤炭的贡献最直接。分项之间, Cement 与 Other 为 0.91、Oil 与 Gas 为 0.90、Coal 与 Cement 为 0.89、 Coal 与 Other 为 0.89,属于强正相关;Flaring 与其余各项的相关性普遍在 0.4 以下, PerCapita 与各分项的相关系数都在 0.1 附近,说明人均指标与总量指标刻画的是不同侧面。 Year 与 Total 的相关系数只有 0.13,因为国家之间的量级差异把时间趋势掩盖掉了, 考察时间趋势要看按年聚合后的折线图而不是原始列的相关性。
9.4 结果验证
逐条核对,每条都能明确判定通过或不通过:
- 交互式会话里
mdf.printSchema()的输出中,Country为string,Year为int,
Total、Coal、Oil、Gas、Cement、Flaring、Other、PerCapita 为 数值类型,没有一列是 string。
country_total.show(10)输出的第一行是总量最大的国家,第十行是乌克兰,共返回
十行。
Correlation.corr得到的矩阵是九行九列,主对角线九个元素全部为 1,矩阵关于对角线
对称。
- 相关系数矩阵中
Total与Coal的值为 0.92252468,Cement与Other的值为
0.90823967,误差在小数点后六位以内。
- 终端最后一行打印
进程已结束,退出代码0,说明脚本没有异常退出。 hdfs dfs -ls /co2/的输出中同时存在analyst-ml-1、analyst-ml-2、
analyst-ml-3 三个目录,且前两个目录下能看到以 part- 开头的文件。
- Jupyter 中逐个单元格执行后,依次得到柱状图、饼图、中国折线图、全球分项折线图、
相关性热力图、分项对比柱状图、人均趋势折线图、百年趋势折线图、散点图共九张图, 没有单元格抛异常。
- 柱状图与饼图给出的前十名国家顺序一致,饼图中最大一块的标注为 35.5%。
- 中国折线图的纵轴范围约在 9750 到 11500 之间,2016 年是这十年的最低点。
9.5 常见问题
| 现象 | 原因 | 处理 | |
|---|---|---|---|
AnalysisException: Path does not exist: hdfs://localhost:9000/user/xmw/dataset.csv | 数据文件没有上传到 HDFS,或路径写错 | 先 hdfs dfs -ls /user/xmw/ 确认文件在,再 hdfs dfs -put -f dataset.csv /user/xmw/dataset.csv 重新上传 | |
求和结果为字符串拼接,或 printSchema() 里各列都是 string | 读 CSV 时没有加 inferSchema=True | 在 spark.read.csv 里补上 inferSchema=True,必要时对该列显式 cast 为数值类型 | |
org.apache.spark.SparkException: Job aborted due to stage failure ... Task not serializable | 在 map/foreach 里直接引用了驱动端的对象或 Pandas 数据结构 | 改用 toPandas() 后再在本地做 Pandas 运算,或把矩阵经 file:/// 本地临时文件中转后再 spark.read.csv 读回 | |
Py4JJavaError: ... Path already exists: /co2/analyst-ml-1 | 输出目录已存在,Spark 的 csv/parquet 写入默认不覆盖 | 改成 write.mode("overwrite"),或先 hdfs dfs -rm -r /co2/analyst-ml-1 | |
ModuleNotFoundError: No module named 'geopandas' | 当前 Python 环境没装 geopandas | 在同一个环境里 pip install geopandas,注意要在启动 Jupyter 的那个环境里装 | |
geopandas.datasets.get_path 找不到 naturalearth_lowres | geopandas 新版移除或改了内置数据集的位置 | 换用与当前版本匹配的调用方式,或把世界边界文件下载到本地后按文件路径 read_file | |
| 地图画出来一片空白或国家名对不上 | 底图里的国家名列是 name,与数据集里的 Country 不一致 | 合并前先 world.rename(columns={"name": "Country"}, inplace=True) | |
ValueError: The truth value of a Series is ambiguous | 对 Pandas 的列直接用了 Python 的 and/or | 用 &、` | 并给每个条件加括号,例如 (df.Year >= 2012) & (df.Year <= 2021)` |