Spark SQL 原理及应用
3.1 这是什么
本章要在已经装好的 Spark 与 MySQL 上,用 Spark SQL 走一遍结构化数据的读写:先在 MySQL 里建一个库和一张表,装进几行样例数据,再把这份数据读成 Spark 的 DataFrame,最后用 Spark SQL 往同一张表里追加数据,回到 MySQL 里查一遍确认数据确实落了库。产出物是一段能在 spark-shell 里逐行跑通的读写流程,以及 MySQL 侧的查询结果。
Spark SQL 是 Spark 上处理结构化数据的模块,提供 DataFrame API 与 SQL 两种用法。既可以用 df.select(...) 这种函数式写法,也可以把 DataFrame 注册成临时表后用 spark.sql("SELECT ...") 写 SQL。两种写法最终走同一个查询引擎,可以在同一段程序里混着用。
DataFrame 是带 schema 的分布式数据集。schema 指数据的列名与列类型定义,有了它,Spark 才能把数据当表来用,才能做列裁剪、谓词下推这类优化。RDD 与 DataFrame 的区别在这里:RDD 只描述数据分片,元素类型由程序自己保证,Spark 看不见元素的内部结构;DataFrame 在 RDD 之上多了一层列式描述,Spark 知道每一列叫什么、是什么类型,因此能优化执行计划,写出来的代码也更短。
Shark 是 Spark SQL 的前身。它早期基于 Hive,做法是改 Hive 的执行引擎,把 Hive 的 SQL 解析与元数据管理接到 Spark 上。这条路一开始走通得很快,但维护困难:Shark 的代码与 Hive 深度耦合,Hive 每升级一次就要跟着改一遍,优化器也受 Hive 限制。社区后来放弃 Shark,把它重写成一个独立实现,也就是现在的 Spark SQL。
JDBC 是 Java 访问数据库的标准接口,Spark SQL 通过它连 MySQL:给出 URL、驱动类名、表名和账号密码,Spark 就能把 MySQL 里的表读成 DataFrame,反过来也能把 DataFrame 写回表里。spark-shell 是 Spark 自带的交互式命令行,本质是一个预先准备好 SparkSession 对象的 Scala 解释器,适合边试边跑。
在整体流程里,本章处在上半程:前面依赖第 1 章装好的 Spark(1.3.6 节)与 MySQL(1.3.9 节),后面第 7、8 章的电影推荐系统要把数据集与推荐结果在 HDFS、MySQL 之间来回搬,用的就是这一章的结构化数据读写。
3.2 前置条件
- Linux 虚拟机已经按第 1 章装好并开机,当前用户对
$SPARK_HOME目录有读写权限。 - JDK 已安装:执行
java -version,输出里能看到1.8.0或更高的1.8.x。 - Hadoop 已启动:执行
jps,输出里同时有NameNode、DataNode、SecondaryNameNode。 - Spark 已安装:执行
ls $SPARK_HOME/bin/spark-shell,文件存在且可执行。 - MySQL 已安装并启动:执行
service mysql status,状态为running;执行mysql -uroot -p能进入mysql>提示符。 - 知道本机 MySQL 的
root密码,后面 JDBC 连接和 Python 脚本都要用。示例里统一写成hadoop,实际按自己的改。 - MySQL 的 JDBC 驱动 jar 在 Spark 的 jar 目录下:
# 执行目录:任意目录,用绝对路径列出
ls /usr/local/spark/jars/mysql-connector-java-*.jar
ls /usr/local/spark/jars/mysql-connector-java-5.1.45.jar- PyMySQL(或 MySQLdb)已安装,供写数据的 Python 脚本使用:
# 执行目录:用户主目录,用绝对路径判断模块是否可导入
python3 -c "import pymysql; print(pymysql.__version__)"- 掌握少量前置知识:会用
mysql客户端执行create database、create table、insert into、select;看得懂 Scala 里的val、case class与链式调用;知道 RDD 的基本用法(第 1 章的词频统计里已经用过textFile、map、collect)。
3.3 操作步骤
3.3.1 从 Shark 到 Spark SQL 的演进
这一小节先不执行命令,只把这一章用到的技术是哪来的理清楚,后面写代码时才知道为什么是 spark.sql(...) 而不是别的接口。
Shark 的设计思路是复用 Hive 的现成件:SQL 解析、语义分析、元数据全交给 Hive,只把物理执行换成 Spark 的任务。这样早期版本的 Shark 在 Hive 查询上比原生 MapReduce 快很多,代价是与 Hive 的代码绑得太紧。Hive 的优化器只能做规则式的改写,Shark 想加基于代价的优化就要动 Hive 的地基;Hive 换一次版本,Shark 就得跟着适配。项目继续往前走的成本越来越高。
Spark SQL 换了一条路:不再复用 Hive 的执行引擎,而是自己在 Spark 上做一套查询引擎,只保留对 Hive 元数据和 HiveQL 语法的兼容。数据描述抽象成 DataFrame 与 schema,执行计划可以用 Catalyst 优化器做分析、逻辑优化与物理计划选择;同时接入了 SQL 解析器,让 spark.sql("...") 直接可用。旧版 HiveContext 能跑的东西,在 SparkSession 下有对应的入口。
从版本上看,Spark 1.0 引入 Spark SQL,Spark 2.0 之后 SparkSession 成为统一入口,SQLContext 与 HiveContext 逐步被取代。本章后面的命令都按 SparkSession 的写法来。
3.3.2 Spark SQL 与 DataFrame
这一小节说明 DataFrame 是什么、和 RDD 差在哪,为 3.3.3 的操作打底。
DataFrame 可以理解成"带表头的分布式表"。它有三个特点:
- 有 schema:列名与列类型是明确给出的,不是靠程序约定;
- 分布式:数据按分区散在集群上,
show()只是把前若干行拉回终端; - 可当表用:注册成临时视图之后,就能用 SQL 语句查它,和查数据库里的表写法一致。
schema 可以来自数据源本身的描述(MySQL 表的列定义、Parquet 文件里存的元数据),也可以由程序指定。从 MySQL 读表时,列名和类型直接沿用建表语句,不需要手写。
RDD 与 DataFrame 的差别用一句话比较:RDD 面向"元素",DataFrame 面向"列"。要做聚合统计,RDD 得自己写 map 与 reduceByKey,DataFrame 可以直接 groupBy("gender").count()。RDD 的类型检查发生在编译期但只在程序这一侧,DataFrame 的列信息 Spark 也知道,所以它能重排算子顺序、跳过用不到的列。代价是 DataFrame 上的操作要通过查询引擎,个别细粒度的自定义操作还是要退回 RDD 做。
DataFrame 是分布式的,所以拿到的不是一个本地集合。要看结果用 show(n);要落到本地内存做后续 Python 处理才用 collect(),数据量大时不要随便 collect()。
3.3.3 启动 spark-shell 做 DataFrame 基础操作
这一小节在交互环境里把 DataFrame 建起来、查一遍,先不碰数据库。
进入 Spark 安装目录并启动交互式命令行:
# 执行目录:Spark 安装目录
cd /usr/local/spark
bin/spark-shell
启动成功的标志是出现 Spark context available as 'sc' 与 Spark session available as 'spark' 两行,随后是 scala> 提示符。下面的 Scala 代码都在这个 scala> 提示符下逐行输入,工作目录就是刚才 cd 进去的 /usr/local/spark。
先读 Spark 自带的一份 JSON 样例,它自带 schema,适合观察 DataFrame 的结构:
val df = spark.read.json("file:///usr/local/spark/examples/src/main/resources/people.json")
df.show()
df.printSchema()
show() 按表格形式打印若干行,printSchema() 打印列的树形结构,输出里应当看到 name 与 age 两列。
接着按列取值,体验 DataFrame 与 RDD 的写法差异:
df.select("name").show()
df.select($"name", $"age" + 1).show()
df.filter($"age" > 20).show()
df.groupBy("age").count().show()
把数值列做运算时要用 $ 取出 Column 对象;这一步如果忘了 import spark.implicits._,会报找不到 $ 符号的错误。
再从 RDD 转出 DataFrame,这一步把 schema 显式交给 Spark:
import spark.implicits._
case class Person(name: String, age: Long)
val peopleDF = spark.sparkContext
  .textFile("file:///usr/local/spark/examples/src/main/resources/people.txt")
  .map(_.split(","))
  .map(x => Person(x(0), x(1).trim.toInt))
  .toDF()
peopleDF.show()
case class 定义好字段名与类型之后,toDF() 就按这些定义生成 schema。字段名不要与 Scala 关键字冲突,类型要和数据对得上,toInt 转换失败时任务会报 NumberFormatException。
最后把 DataFrame 注册成临时视图,用 SQL 查它:
peopleDF.createOrReplaceTempView("people")
val result = spark.sql("SELECT name, age FROM people WHERE age > 20")
result.show()
临时视图只在当前 spark-shell 会话内有效,退出就没了,它不落任何文件。要长期保存得用 saveAsTable 写进元数据仓库。
退出交互环境用 :quit,或者按 Ctrl+D。
3.3.4 MySQL 侧准备数据库与表
这一小节把数据落点建好:建库、建表,再用 Python 脚本灌入几行样例数据。
用 root 登录 MySQL:
# 执行目录:任意目录,直接用客户端命令
mysql -uroot -p
回车后输入密码(示例为 hadoop),进入 mysql> 提示符。下面的 SQL 都在这个提示符下执行。
建库、切库、建表,建库时指定字符集,避免后面写入中文出现乱码:
CREATE DATABASE spark DEFAULT CHARACTER SET utf8;
USE spark;
CREATE TABLE student (
  id INT(11) NOT NULL,
  name VARCHAR(20) NOT NULL,
  gender VARCHAR(10) NOT NULL,
  age INT(11) NOT NULL,
  PRIMARY KEY (id)
);三条语句的解释:CREATE DATABASE 建库;USE 切换到该库,之后的表都建在它下面;CREATE TABLE 建表,四个字段与本章用到的样例数据一一对应,id 作主键。建完看库与表是否都在:
SHOW DATABASES;
USE spark;
SHOW TABLES;
SELECT * FROM student;
最后一条 SELECT 此时返回空集,表结构已经就位。
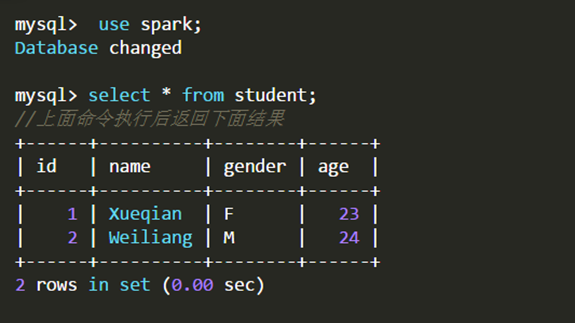
手工插一行,验证表能被写入:
INSERT INTO student VALUES(1,'Xueqian','F',23);
INSERT INTO student VALUES(2,'Weiliang','M',24);
SELECT * FROM student;
INSERT 的返回是 Query OK, 1 row affected,随后 SELECT 能查到刚写进去的行。MySQL 教程里的 Xueqian、Weiliang、Rongcheng、Guanhua 是自带样例数据,可以直接用。
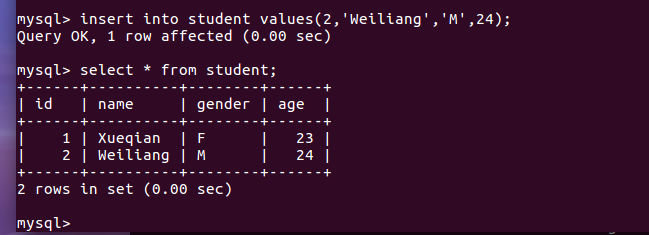
批量数据用 Python 脚本灌入。脚本用 PyMySQL 连本机 MySQL,逐条 execute 再 commit,放在用户主目录下,文件名为 insertdata.py:
# 文件路径:~/insertdata.py
import pymysql

conn = pymysql.connect(host='localhost', user='root', password='hadoop',
                       database='spark', charset='utf8')
cur = conn.cursor()
rows = [(3, 'Rongcheng', 'M', 26), (4, 'Guanhua', 'M', 27)]
cur.executemany("INSERT INTO student VALUES(%s,%s,%s,%s)", rows)
conn.commit()
cur.close()
conn.close()
在脚本所在目录执行它:
# 执行目录:insertdata.py 所在目录(用户主目录)
cd ~
python3 insertdata.py
脚本按约定不打印任何输出,跑完没有报错即为成功;数据是否真的进去,回 MySQL 里查:
SELECT * FROM student;应当看到四行数据:
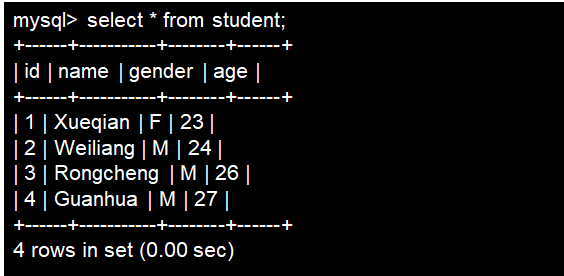
如果脚本报 ModuleNotFoundError: No module named 'pymysql',先装模块:pip3 install pymysql。
3.3.5 用 Spark SQL 读写 MySQL
这一小节做本章的核心动作:用 JDBC 把 MySQL 的表读成 DataFrame,再把 DataFrame 追加写回 MySQL。
回到第一个终端,确保 spark-shell 已经启动(命令与工作目录同 3.3.3 节:cd /usr/local/spark 后执行 bin/spark-shell)。读写 MySQL 需要 JDBC 驱动可见,先确认 jar 在 Spark 的 jar 目录里,不在的话可以在启动时用 --jars 指定:
# 执行目录:Spark 安装目录
cd /usr/local/spark
ls jars/mysql-connector-java-*.jar
# 若 jar 放在别处,改用下面的方式启动
bin/spark-shell --jars /usr/local/spark/jars/mysql-connector-java-5.1.45.jar
驱动 jar 缺失时的典型报错是 java.sql.SQLException: No suitable driver found for jdbc:mysql://localhost:3306/spark,加 --jars 或把 jar 放进 jars/ 目录都能解决。
下面这段 Scala 代码都在 scala> 提示符下逐行输入,工作目录是 /usr/local/spark。用 spark.read.format("jdbc") 读出 student 表:
val jdbcDF = spark.read.format("jdbc")
  .option("url", "jdbc:mysql://localhost:3306/spark?useUnicode=true&characterEncoding=utf8")
  .option("driver", "com.mysql.jdbc.Driver")
  .option("dbtable", "student")
  .option("user", "root")
  .option("password", "hadoop")
  .load()
jdbcDF.show()
jdbcDF.printSchema()
format("jdbc") 说明数据源类型,option 依次给连接地址、驱动类名、表名、账号、密码。url 里的 3306 是 MySQL 默认端口,spark 是库名;末尾两个参数把连接的字符集设成 UTF-8。驱动类名要跟着 jar 的版本走:5.x 的 connector 用 com.mysql.jdbc.Driver,8.x 的用 com.mysql.cj.jdbc.Driver,写错会报 java.lang.ClassNotFoundException。
读出来的 jdbcDF 就是一张 DataFrame,可以直接查、也可以注册成临时视图写 SQL:
jdbcDF.createOrReplaceTempView("student")
spark.sql("SELECT name, gender, age FROM student WHERE age > 23").show()
只取需要的列可以减少从 MySQL 拉回的数据量,宽表上差别明显。
接着把 DataFrame 写回 MySQL,先手工造两张新行的 DataFrame:
import spark.implicits._
case class Student(id: Int, name: String, gender: String, age: Int)
val studentDF = spark.sparkContext
  .parallelize(Array("5 Rongheng M 26", "6 Guanhua M 27"))
  .map(_.split(" "))
  .map(p => Student(p(0).trim.toInt, p(1), p(2), p(3).trim.toInt))
  .toDF()
studentDF.show()
写回用 df.write.mode("append").format("jdbc"):
import java.util.Properties
val prop = new Properties()
prop.put("user", "root")
prop.put("password", "hadoop")
prop.put("driver", "com.mysql.jdbc.Driver")
studentDF.write.mode("append")
  .jdbc("jdbc:mysql://localhost:3306/spark", "student", prop)
也可以沿用上面 option 的写法:
studentDF.write.mode("append").format("jdbc")
  .option("url", "jdbc:mysql://localhost:3306/spark?useUnicode=true&characterEncoding=utf8")
  .option("driver", "com.mysql.jdbc.Driver")
  .option("dbtable", "student")
  .option("user", "root")
  .option("password", "hadoop")
  .save()
mode 决定目标已存在时怎么办:append 追加、overwrite 覆盖建新表、ignore 跳过、error 直接报错。这里用 append,因为表是 3.3.4 节建好的,要往里加行。write 是行动算子,提交后会真的启动 Spark 作业,终端会滚动打印任务日志;只 read 不 write 时也可能因为 show() 触发一次读取作业。
作业要求把本人的编号与姓名写进同一张表。这里用占位符 SERIAL 与 yourname 代替,实际执行时换成自己的编号与姓名,再跑一次 append:
val meDF = spark.sparkContext
  .parallelize(Array(Array("7", "SERIAL_yourname", "M", "24")))
  .map(p => Student(p(0).toInt, p(1), p(2), p(3).toInt))
  .toDF()
meDF.show()
meDF.write.mode("append").jdbc("jdbc:mysql://localhost:3306/spark", "student", prop)
提交后 Spark 日志里出现作业完成的行,说明这次写入已经跑完:
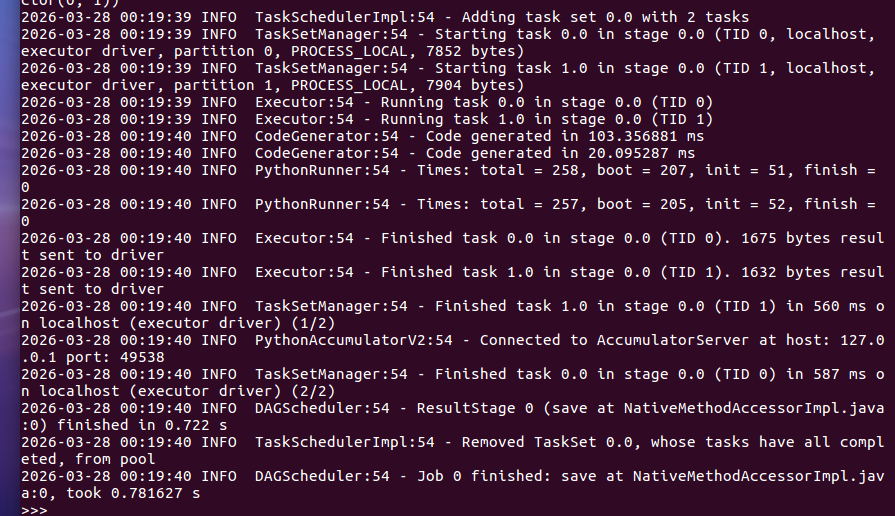
回到 MySQL 客户端(3.3.4 节那个 mysql> 提示符,或重新 mysql -uroot -p 登录),查一遍:
USE spark;
SELECT * FROM student;
新追加的行出现在结果里。至此读、写两个方向都验证过一遍。
3.4 结果验证
mysql -uroot -p登录后执行USE spark;返回Database changed,说明库存在。- 执行
SHOW TABLES;的输出里有student;执行DESC student;能看到id、name、gender、age四列及其类型。 cd ~ && python3 insertdata.py执行完成后没有报错,随后SELECT * FROM student;能查到脚本写入的行。spark-shell里jdbcDF.show()打印出的列名与 MySQL 建表语句一致,行数等于当时student表里的行数。jdbcDF.printSchema()输出中id与age为整型、name与gender为字符串,没有出现全部列都是string的情况。- 执行
studentDF.write.mode("append").format("jdbc")...save()后,回 MySQL 执行SELECT * FROM student;,行数比写入前增加,且新增的正是 DataFrame 里的内容。 - Spark 日志里出现
Job 0 finished这类作业完成行,且没有ERROR与Exception打头的堆栈。 - 表里出现中文字段值时查询不显示乱码,说明建库语句与 JDBC URL 都按 UTF-8 设置了字符集。
- 重复执行一次
append写入相同主键会报主键冲突,这是预期行为;换一个新id就能成功,说明写入确实落到了 MySQL 而不是只留在 Spark 内存里。
3.5 常见问题
| 现象 | 原因 | 处理 | |
|---|---|---|---|
java.sql.SQLException: No suitable driver found for jdbc:mysql://localhost:3306/spark | Spark 的 classpath 里没有 MySQL JDBC 驱动 | 把 mysql-connector-java-*.jar 放进 $SPARK_HOME/jars/,或启动时加 --jars 指向该 jar | |
java.lang.ClassNotFoundException: com.mysql.jdbc.Driver | 驱动类名与实际 jar 版本不匹配 | 5.x 的 connector 用 com.mysql.jdbc.Driver,8.x 改用 com.mysql.cj.jdbc.Driver | |
com.mysql.jdbc.exceptions.jdbc4.CommunicationsException: Communications link failure | MySQL 服务没起来,或端口、主机写错 | service mysql status 确认在跑;`netstat -anp \ | grep 3306 确认在监听;url` 里的主机端口与实际一致 |
Access denied for user 'root'@'localhost' (using password: YES) | JDBC 或脚本里的密码不对 | 用 mysql -uroot -p 手工登录一次核对密码,再同步改 option("password", ...) 与 insertdata.py 里的 password | |
Table 'spark.student' doesn't exist | 库名或表名拼错,或建表时 USE 的不是同一个库 | 在 MySQL 里 USE spark; SHOW TABLES; 确认表在哪个库,再对齐 url 里的库名与 dbtable | |
ModuleNotFoundError: No module named 'pymysql' | Python 环境里没装 MySQL 驱动模块 | pip3 install pymysql 后重跑脚本;用 MySQLdb 的项目则装 mysqlclient | |
| 查询结果里中文显示为乱码 | 建库建表时没指定字符集,或 JDBC URL 没开 UTF-8 | 建库时带 DEFAULT CHARACTER SET utf8;JDBC URL 加上 useUnicode=true&characterEncoding=utf8 | |
Duplicate entry '1' for key 'PRIMARY' | append 写入的行与表里已有主键重复 | 换一个新的 id 再写,或先 DELETE FROM student WHERE id=... 清掉旧行 |