电影推荐系统(升级版)的设计与实现
8.1 这是什么
本章把第 7 章做出来的基础版电影推荐系统升级成一套完整的 Web 应用。基础版只有一条链路:把数据放进 HDFS,用 Spark 跑一遍 ALS 算出推荐结果,再用一个 Node.js 页面把结果贴出来。它没有数据库,电影的名字、海报、用户信息都散落在文件里;页面也只有一页,换个用户就得改代码重跑。升级版要解决的就是这两件事:把电影元数据和用户信息放进 MySQL 统一管理,把单个页面扩成多页面的站点,让推荐结果和电影海报一起展示。
本章的产出是一套能跑在本机的电影推荐网站:MySQL 里有 movierecommend 库和几张表,Spark 程序把 ALS 的推荐结果写进库里或写成文件,Node.js 的 Express 应用读这些数据,在浏览器 localhost:3000 上把推荐列表连海报一起渲染出来。
用到的东西按出现顺序列出。MySQL 是关系型数据库,用库、表、行、列来存结构化数据,表与表之间靠主键和外键建立关联。主键是能唯一标识一行记录的字段,外键是本表里指向另一张表主键的字段,两者配合能把「谁给哪部电影打了多少分」这类关系拆成多张表而不重复。SQL 脚本是一串写好的建库建表与插入语句,放在一个 .sql 文件里,用 SOURCE 命令一次性执行。Node.js 是让 JavaScript 跑在服务端的运行时环境。Express 是 Node.js 上最常用的 Web 框架,用它可以按 URL 路径把请求分发给不同的处理函数,这种分发规则叫路由。AJAX 是页面在不整体刷新的前提下向服务端取数据的技术,通常配合表单提交或按钮点击使用。ALS 是交替最小二乘法,协同过滤里用矩阵分解做推荐的经典算法,第 7 章已经用它算过推荐。
在整体流程里,本章处在第 7 章之后的收尾位置:前面依赖第 5 章的 ALS 算法、第 6 章的 Node.js 与 Express、第 7 章跑通的推荐结果,以及第 1.3.9 节装好的 MySQL;后面第 9 章的综合实验会复用这里的数据落库与网页展示思路,只是把数据换成 CO₂ 排放量。
8.2 前置条件
开始动手前,先把下面这些逐条核对一遍。
- 虚拟机里的 Hadoop 已经跑起来。执行
jps,输出里能看到NameNode、DataNode、ResourceManager、NodeManager四个进程。 - Spark 已经安装并可用。在终端执行
spark-shell,能进入scala>提示符且不报ClassNotFoundException。 - MySQL 服务已经启动。执行
service mysql status,输出里出现active (running);用mysql -uroot -p能进入mysql>提示符。 - Node.js 与 npm 已经安装。执行
node -v和npm -v,两条命令都能打印出版本号,Node.js 版本建议在 14 以上。 - 第 7 章的推荐结果已经产生。
~/下有 Spark 程序输出的推荐结果目录或文件,/input_spark/ratings.dat已经上传到 HDFS,用hdfs dfs -ls /input_spark能看到它。 - 建库脚本已经准备好。
~/sqljs/目录下有MovieRecommendDatabase.sql(约 29.85 MB),里面有建库、建表和电影元数据(含海报地址)的插入语句。用ls -l ~/sqljs/确认文件存在且体积不为 0。 - 工作目录
~/nodejsAPP/存在。第 6 章的 Node.js 案例都放在这里,本章的项目也建在同一层,用ls ~/nodejsAPP能看到第 6 章留下的项目目录。 - 需要掌握的前置知识有三点:能读懂
create table语句里的字段类型与主外键约束;知道 Express 里app.get(...)是在注册一条路由;能看懂 JavaScript 回调函数收到的err与result两个参数。
8.3 操作步骤
8.3.1 升级版相对基础版改了什么
先把差异列清楚,后面每一步都能对上是为哪一条服务的。
第一,引入 MySQL 存电影元数据与用户信息。基础版里电影名和海报地址写在代码里,或者从文件里临时读;升级版把电影信息、用户信息、评分记录、推荐结果分表存进 movierecommend 库,页面通过 SQL 查询取数据,改数据不用改代码。
第二,页面从单页变成多页面。基础版只有一个展示页;升级版拆出登录页、推荐列表页、电影详情页等若干页面,靠 Express 路由按路径分发,公共部分(导航、样式)抽出来复用。
第三,推荐结果与电影海报一起展示。基础版的结果表只有用户编号、电影编号和预测评分三个数字;升级版拿电影编号去 movieinfo 表里查出片名与海报地址,把海报图片和推荐理由一起渲染到页面上。
第四,推荐结果从「跑完打印」变成「落库或落文件」。基础版在 spark-shell 里打印 Top N 就结束了;升级版的 Spark 程序把结果写到固定位置,Node.js 每次请求直接读,不必重新跑一遍推荐。
在整体流程里的位置:第 7 章(基础版链路) -> 本章 3.3 建库 -> 3.4 结果落库 -> 3.5 多页面站点8.3.2 系统整体流程与页面设计
系统只做一件事:浏览器发来请求,服务端取出「该用户可能喜欢的电影」,再连上海报渲染回去。整条链路如下。
用户请求先到 Node.js。Express 按 URL 路径判断这是登录、推荐列表还是电影详情,交给对应处理函数。处理函数里做两类查询:一类去 MySQL 取电影片名、海报地址和用户信息,另一类读 Spark 已经算好的推荐结果。两类数据在服务端拼成页面需要的数据结构(数组或对象),再交给模板或直接以 JSON 返回给浏览器。浏览器的 AJAX 拿到 JSON 后,把海报和图注填进页面。
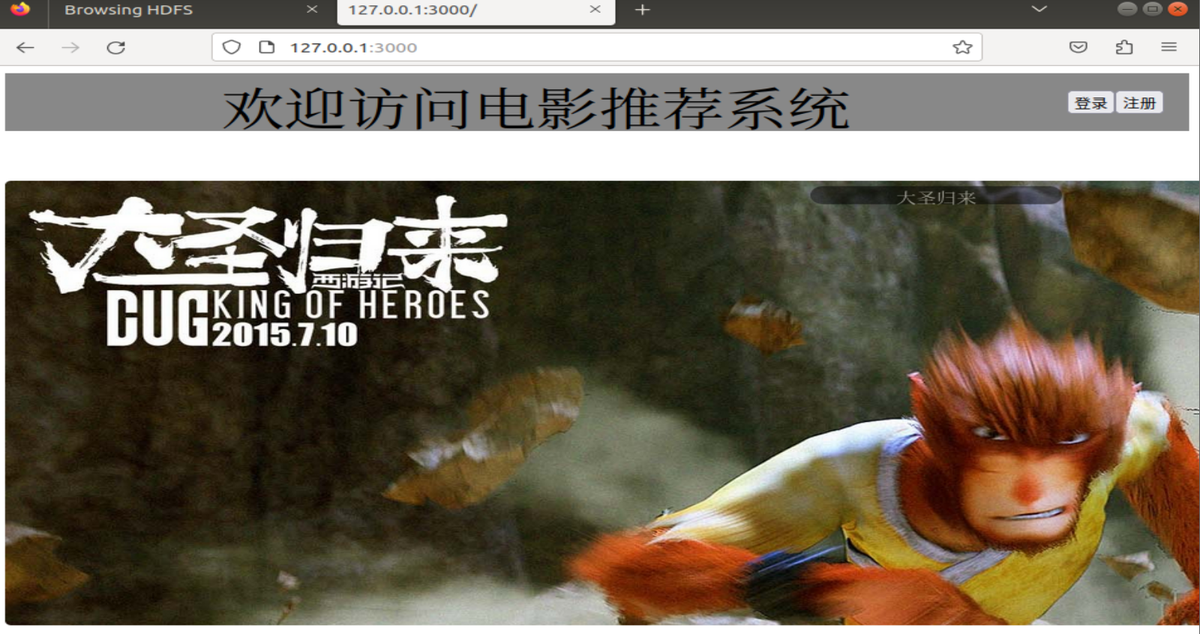
页面分三块:登录页负责拿到用户名;推荐列表页是主体,按预测评分从高到低排出一列电影卡片,每张卡片是海报加片名;电影详情页在用户点某张卡片后打开,展示该片的完整信息。公共的导航条与样式放在模板的公共部分,各页面只写自己的内容块。
下面这张图是升级版系统的页面设计效果。
8.3.3 设计并建立 MySQL 数据库
这一步创建 movierecommend 数据库,并执行素材里的建库脚本把表结构和电影元数据一次性导入。
先进入 MySQL 命令行。-u 后面跟用户名,-p 表示接下来会提示输入密码,回车后输入密码即可进入 mysql> 提示符。
# 任意目录下均可执行
mysql -uroot -p进入命令行后,创建数据库并切换过去。create database 只建一个空库,use 把后续语句的作用范围切到这个库,不写 use 后面的语句会报 No database selected。
create database movierecommend;
use movierecommend;
接着执行建库脚本。素材里的脚本放在 ~/sqljs/MovieRecommendDatabase.sql,用 SOURCE 导入:SOURCE 是 MySQL 客户端的命令,它把指定文件里的 SQL 语句按行读进来依次执行,效果等同于手工把整个文件粘贴进命令行,但不用担心行数太多。脚本文件接近 30 MB,执行需要等一会儿。
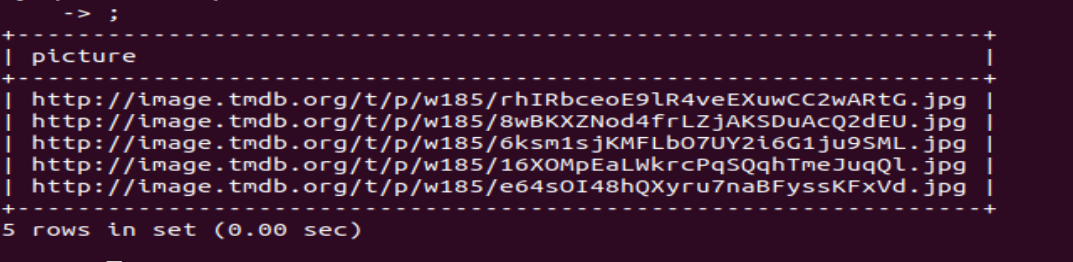
SOURCE ~/sqljs/MovieRecommendDatabase.sql;导入完成后验证一下。下面这条语句从 movieinfo 表里取 picture 字段的前 5 行,limit 5 表示只要 5 条,目的是确认海报地址确实进了库。
select picture from movieinfo limit 5;正常会返回 5 行 URL 形式的字符串,形如 http://…/poster/xxx.jpg。如果返回 Empty set,说明脚本没执行成功,回到上一步重跑 SOURCE。
数据库里的表按职责分成四类,字段设计如下。
movieinfo(电影信息表)存电影元数据,主键是 movieid,主要字段有 title(片名)、picture(海报地址)、genres(类型,如 Action、Comedy)、director(导演)、actors(主演)。这张表是推荐结果能被看懂的基础,没有它页面只能显示电影编号。
userinfo(用户信息表)存用户资料,主键是 userid,字段有 username(登录名)、password(密码)、email(邮箱)。userid 与第 7 章 ALS 输入里的用户编号对应,这样算出来的推荐才能落到具体用户头上。
ratings(评分表)存用户对电影的打分,字段有 userid、movieid、rating(评分)、timestamp(打分时间)。userid 是指向 userinfo 主键的外键,movieid 是指向 movieinfo 主键的外键。把评分单独拆一张表,是为了避免在用户表里重复存电影信息,也不在电影表里重复存用户信息。
recommend(推荐结果表)存 Spark 算出来的结果,字段有 userid、movieid、rating(预测评分)。它由 Spark 程序写入,被 Node.js 读取,是数据库和计算程序之间的交接点。
表关系可以用下面这张图表示:用户表与电影表都是「一」,评分表是「多」,一条评分必须同时属于一个用户和一部电影。
下面这张图是数据库设计相关的界面截图。
8.3.4 Spark 程序的设计
这一步沿用第 7 章的 ALS 程序,只改变结果的去向:不再只往终端打印,而是落到数据库或写成文件,供网页读取。
程序的主体与第 7 章一致:从 HDFS 读评分数据,用 Ratings 解析成 userid、movieid、rating 三元组,切出训练集与测试集,调用 ALS.train 训练模型,再用 model.predict 对测试集打分并算 RMSE。区别在最后一段。
结果落库用 spark-shell 交互式操作时,可以借 JDBC 把 DataFrame 写回去。下面这段在 spark-shell 的 scala> 提示符下逐句执行,url 里的库名、用户名、密码按本机实际情况替换。
// 在 spark-shell 的 scala> 提示符下执行
val url = "jdbc:mysql://localhost:3306/movierecommend?useSSL=false"
val prop = new java.util.Properties()
prop.setProperty("user", "root")
prop.setProperty("password", "你的密码")
val recommendDF = spark.createDataFrame(recommendRDD).toDF("userid", "movieid", "rating")
recommendDF.write.mode("append").jdbc(url, "recommend", prop)
jdbc 是 Java 访问数据库的标准接口,Spark 的 DataFrameWriter 内置了它,mode("append") 表示追加写入而不是覆盖。写之前确认 recommend 表已经建好且字段顺序与 DataFrame 一致,否则会报字段不匹配。
如果本机 JDBC 驱动不方便配置,也可以退一步只写文件:用 recommendRDD.saveAsTextFile("/output_spark/recommend") 把结果落到 HDFS,Node.js 侧读文件解析,效果对页面来说是一样的。两种方式选一种即可,不要在同一个流程里混用。
下面是用 Scala 独立程序(ALSRecommender.scala)运行时要注意的两点:一是打包提交时要把 MySQL 驱动一起带上,二是提交命令里 --jars 指定驱动的 jar 路径。
# 在项目根目录(例如 ~/sparkapp)下执行
spark-submit --class ALSRecommender \
  --jars ~/sparkapp/mysql-connector-java-5.1.47.jar \
  --master local[*] \
  ~/sparkapp/target/als-movie.jar
跑完后到数据库里核对结果。下面这条语句从结果表里取前 10 条,看预测评分是否落在合理区间。
select * from recommend limit 10;8.3.5 系统网站的设计与实现
这一步在 ~/nodejsAPP/movierecommendapp 下建 Node.js 项目,装依赖,写服务端脚本,最后启动站点。
先创建项目目录并初始化。npm init 会交互式地问项目名称、版本、入口文件等信息,一路按 Enter 接受默认值即可,确认后目录里会多出一个 package.json,它记录项目信息和依赖清单。
# 在家目录下执行
cd ~/nodejsAPP
mkdir movierecommendapp
cd movierecommendapp
npm init
接着安装 Express 与 MySQL 驱动。Express 负责路由与静态资源,mysql 是 Node.js 连 MySQL 的驱动,它把 TCP 连接、协议握手和结果集解析都封装成回调式的 API,用起来就是「建连接池 → 发查询 → 在回调里拿 results」。
# 在 ~/nodejsAPP/movierecommendapp 目录下执行
npm install express --save
npm install mysql --save
--save 会把依赖写进 package.json 的 dependencies,换一台机器时执行 npm install 就能装回同样的版本。
然后写服务端脚本 index.js。下面这份脚本做了三件事:建立数据库连接池,注册一条推荐列表路由,启动服务监听 3000 端口。
// 文件位置:~/nodejsAPP/movierecommendapp/index.js
var express = require('express');
var mysql = require('mysql');
var app = express();

// 建立数据库连接池,避免每次请求都重新握手
var pool = mysql.createPool({
  host: 'localhost',
  user: 'root',
  password: '你的密码',
  database: 'movierecommend'
});

// 路由一:返回某个用户的推荐列表,推荐结果与电影信息在 SQL 里关联
app.get('/recommend', function (req, res) {
  var userid = req.query.userid || 1;
  var sql = 'select r.movieid, r.rating, m.title, m.picture ' +
            'from recommend r, movieinfo m ' +
            'where r.movieid = m.movieid and r.userid = ? ' +
            'order by r.rating desc limit 20';
  pool.query(sql, [userid], function (err, results) {
    if (err) {
      res.status(500).json({ error: err.message });
      return;
    }
    res.json(results);
  });
});

// 路由二:返回电影详情
app.get('/movie/:movieid', function (req, res) {
  pool.query('select * from movieinfo where movieid = ?',
    [req.params.movieid], function (err, results) {
      if (err) { res.status(500).json({ error: err.message }); return; }
      res.json(results[0] || {});
    });
});

// 静态页面放在 public 目录,Express 直接托管
app.use(express.static('public'));

app.listen(3000, function () {
  console.log('Movie recommend app listening on port 3000');
});
脚本里 ? 是参数占位符,pool.query 的第二个参数数组会按顺序替换它,这样能避免把用户输入直接拼进 SQL 造成注入。req.query.userid 取的是地址栏查询串里的 userid,req.params.movieid 取的是路径里的那一段。
前端页面放在 ~/nodejsAPP/movierecommendapp/public/ 下,用 AJAX 取数据。下面这段是推荐列表页的核心逻辑,页面加载完后请求 /recommend,把返回的数组拼成电影卡片。
// 文件位置:~/nodejsAPP/movierecommendapp/public/index.html 内的 script
fetch('/recommend?userid=1')
  .then(function (res) { return res.json(); })
  .then(function (list) {
    var box = document.getElementById('list');
    list.forEach(function (m) {
      var card = document.createElement('div');
      card.className = 'card';
      card.innerHTML = '<img src="' + m.picture + '" width="120">' +
                       '<p>' + m.title + '</p>' +
                       '<p>预测评分 ' + m.rating.toFixed(2) + '</p>';
      box.appendChild(card);
    });
  });
fetch 是浏览器内置的请求接口,返回的 Response 要再调 .json() 才能拿到对象。页面里的 #list 容器是空的,数据到位后才被填满,这就是 AJAX 的典型用法。表单提交的场景类似,登录页给 <form> 绑定 onsubmit,在读走输入值前先调 event.preventDefault() 阻止页面整体刷新,再用同样的方式发请求。
最后启动站点。
# 在 ~/nodejsAPP/movierecommendapp 目录下执行
node index.js
终端打印 Movie recommend app listening on port 3000 后,浏览器访问 http://localhost:3000。注意这个地址是在虚拟机内部使用的,如果从宿主机浏览器访问,要把 localhost 换成虚拟机的 IP,并确认虚拟机的 3000 端口没有被防火墙拦住。
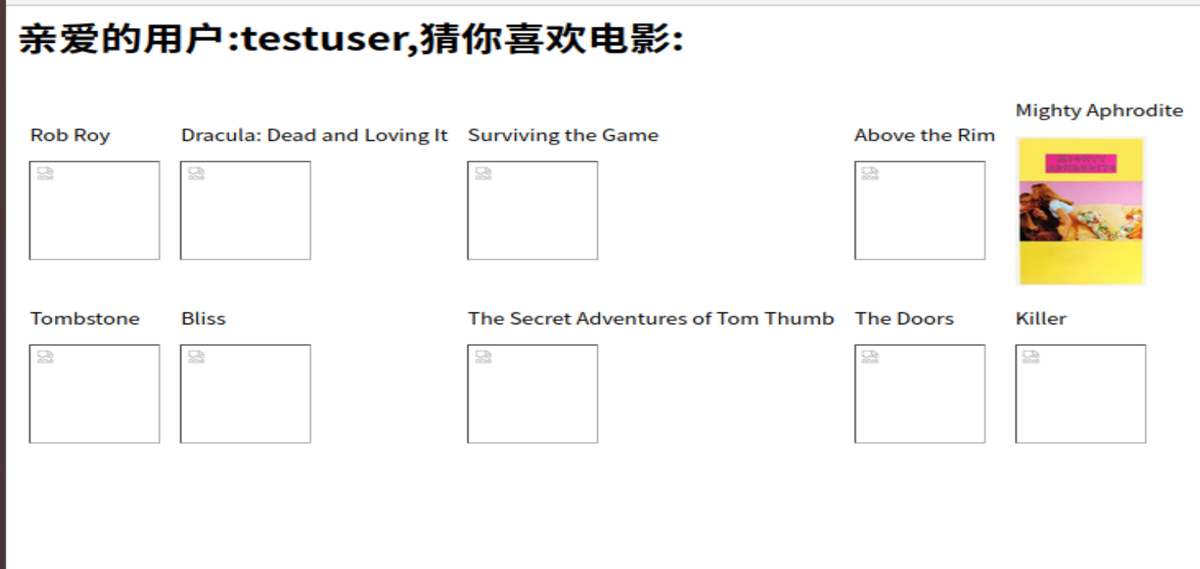
下面两张图分别是站点的页面结构与运行效果。
8.3.6 本章问题的解决方案
把下面这些高频问题按处理顺序归纳一遍,遇到时照这个次序排查。
第一类,数据库层。No database selected 说明漏了 use movierecommend;;SOURCE 报 Failed to open file 说明路径写错了,脚本必须用绝对路径或 ~/ 开头的家目录路径;脚本跑完但查询为空,先 show tables; 确认表建出来了,再 select count(*) from movieinfo; 确认数据进去了,两者都正常才是查询语句的问题。
第二类,连接层。Spark 或 Node.js 连不上 MySQL,先确认 MySQL 服务在跑、3306 端口在监听,再确认用户名密码和库名与建库时一致;报 Access denied 时用 mysql -uroot -p 手工登一次,能登上说明是脚本里的密码写错了。
第三类,Spark 写库失败。报字段数量不匹配,检查 recommend 表的列与 DataFrame 的列是否一一对应;报找不到驱动,检查 spark-submit 的 --jars 是否指到了 jar 的真实路径。
第四类,Node.js 启动失败。Error: listen EADDRINUSE :::3000 表示 3000 端口被占用,用 netstat -tlnp | grep 3000 找到占用进程后结束它,或者把 app.listen 的端口改成 3001 再访问新端口。Cannot find module 'express' 表示依赖没装上,回到 movierecommendapp 目录重新执行 npm install express --save。
第五类,页面空白或海报不显示。打开浏览器开发者工具的 Network 面板看 /recommend 请求的返回:返回 500 说明 SQL 有错,看服务端终端的报错;返回空数组说明该用户没有推荐结果或结果没写进库;数组正常但图片不显示,检查 movieinfo.picture 里的 URL 能否在浏览器里直接打开。
8.4 结果验证
按顺序逐条检查,每条都能明确判定通过或不通过。
- 在
mysql>提示符下执行show databases;,输出里出现movierecommend。 - 执行
use movierecommend; show tables;,输出里至少包含movieinfo、userinfo、ratings、recommend四张表。 - 执行
select picture from movieinfo limit 5;,返回 5 行非空的 URL 字符串,而不是Empty set。 - 执行
select count(*) from recommend;,返回值大于 0,说明 Spark 的结果确实落了库。 - Spark 程序运行结束时,终端打印的
Root-mean-square error数值正常输出且没有抛异常;同时数据库或/output_spark/recommend下能看到新产生的结果。 - 在
~/nodejsAPP/movierecommendapp目录执行node index.js,终端打印Movie recommend app listening on port 3000,且进程不退出。 - 浏览器访问
http://localhost:3000,页面能打开并显示推荐列表。 - 推荐列表里每部电影同时出现海报图片和片名,数量不超过 20 条,且按预测评分从高到低排列。
- 点击任意一张电影卡片,能打开对应的电影详情页,URL 形如
http://localhost:3000/movie/xxxx。 - 浏览器开发者工具的 Network 面板里,
/recommend请求的响应状态码是 200,响应体是 JSON 数组。
8.5 常见问题
| 现象 | 原因 | 处理 | |
|---|---|---|---|
ERROR 1046 (3D000): No database selected | 建表或查询前没有切换到目标库 | 先执行 use movierecommend;,再执行后续语句 | |
Failed to open file '~/sqljs/MovieRecommendDatabase.sql' | 脚本路径不存在,或 SOURCE 不展开波浪号 | 用 ls -l ~/sqljs/ 确认文件,把路径写成绝对路径 /home/hadoop/sqljs/MovieRecommendDatabase.sql 再导入 | |
ERROR 1045 (28000): Access denied for user 'root'@'localhost' | 脚本或连接配置里的密码不对 | 用 mysql -uroot -p 手工登录验证密码,改掉 index.js 和 Spark 脚本里的密码 | |
ERROR 2003 (HY000): Can't connect to MySQL server on 'localhost' (111) | MySQL 服务没启动,或端口不是 3306 | 执行 service mysql status 确认状态,未启动则 service mysql start | |
Root-mean-square error 一直不出,日志停在 Job 阶段 | ALS 在本地模式跑大矩阵迭代慢,或内存不足 | 把 rank、iterations 调小,或把 --master 的 local[*] 改成给更多内存的配置 | |
java.sql.SQLException: No suitable driver found for jdbc:mysql://... | Spark 运行时没有 MySQL 驱动 jar | 下载 mysql-connector-java-5.1.47.jar,用 --jars 指到它的绝对路径 | |
Error: Cannot find module 'express' | 依赖没装,或在错误的目录启动 | 回到 ~/nodejsAPP/movierecommendapp 执行 npm install express mysql --save,再 node index.js | |
Error: listen EADDRINUSE :::3000 | 3000 端口已被别的进程占用 | `netstat -tlnp \ | grep 3000 找到进程后结束它,或把 app.listen` 改成 3001 |
| 页面能打开但列表为空 | /recommend 查不到数据:用户编号不存在,或结果没落库 | 先在 MySQL 里手工执行那条 SQL 看有没有行,再检查 recommend 表的 userid 与请求里的 userid 是否一致 | |
| 页面有片名但海报是碎图标 | movieinfo.picture 里的地址访问不到 | 把该 URL 直接粘进浏览器验证;网络不通时改用本地静态图片目录,由 Express 托管 |