使用 Spark Mlib 实现协同过滤算法
5.1 这是什么
本章用 Spark 自带的机器学习库 MLlib 实现协同过滤算法,在 spark-shell 里跑通推荐模型的训练、评估与 Top-N 结果输出。MLlib 是 Spark 自带的机器学习库,把协同过滤、分类、回归、聚类等常用算法的分布式实现打包在一起,直接调用即可,不需要自己写分布式求解过程。协同过滤是一类推荐算法:它不看物品的内容标签,只看「谁给哪些物品打了多少分」这张历史评分表,从相似的用户或相似的物品出发,推测当前用户还没接触过的物品里哪些值得推荐。
本章实际训练的算法是 ALS。ALS 是交替最小二乘法的缩写,是协同过滤里用矩阵分解做推荐的经典算法:它把一张又大又稀疏的用户—物品评分矩阵拆成两个小得多的矩阵,一个描述用户的口味,一个描述物品的特征,再让这两个小矩阵相乘去逼近原始评分。拆出来的向量就是所谓的隐语义因子,它不直接对应「动作片」「喜剧片」这类人工标签,而是模型自己学出来的抽象维度。
本章使用的数据是 MovieLens 的评分数据集 ratings.dat,数据文件放在 /usr/local/spark/ 目录下,并上传到 HDFS 供 Spark 读取。每行记录包含一个用户、一部电影、该用户对这部电影的评分以及时间戳。程序先建立显式反馈模型(ALS.train),再建立隐式反馈模型(ALS.trainImplicit),最后用均方根误差 RMSE 评价两种模型的预测偏差,并输出 Top-20 推荐结果。RMSE 是均方根误差,衡量预测评分与真实评分之间的平均偏差,数值越小表示预测越贴近真实打分。
本章在整体流程里处在「算法验证」这一步:前面依赖第 1 章装好的 Spark 与 HDFS 环境,以及已经上传到 HDFS 的 ratings.dat;本章训练出来的 ALS 模型与调用方式,会被第 7 章和第 8 章的电影推荐系统直接调用,用来生成面向真实用户的推荐列表。
5.2 前置条件
开始动手前,逐条核对下面的条件。
- JDK 已安装并能正常执行
java -version。 - Hadoop 已安装并完成单机或伪分布式配置,
jps输出里能看到NameNode、DataNode、SecondaryNameNode、ResourceManager、NodeManager进程。 - HDFS 已启动,
hdfs dfs -ls /能正常返回结果而不是报连接异常。 - Spark 已安装在
/usr/local/spark/,/usr/local/spark/bin/spark-shell可以直接启动,启动后能看到scala>提示符。 - 评分数据文件已放在
/usr/local/spark/ratings.dat,且已通过hdfs dfs -put上传到 HDFS,路径为/input_spark/ratings.dat。 - 具备少量 Scala 与 RDD 基础:知道
map、join、take、count的作用,能在spark-shell里输入多行表达式(按回车后提示符变为|表示续行)。 - 机器内存不低于 4 GB。数据量不大,但 ALS 训练与多次 RMSE 计算会反复用到内存。
5.3 操作步骤
5.3.1 推荐系统与协同过滤的原理
推荐系统要做的事,是替用户从海量物品里挑出他可能感兴趣的一小部分。协同过滤是最早成熟、也最常用的一类推荐思路,它的依据只有一张用户—物品评分矩阵:行是用户,列是物品,格子里的数字是评分。真实场景中这张矩阵极其稀疏,一个用户通常只对几百部电影打过分,而电影总数可能是几十万部,矩阵里绝大多数格子是空的,推荐算法的任务就是把这些空格填上。
协同过滤靠「相似」来填空。相似度用来衡量两个用户的口味有多接近,或者两部电影被同一批人喜欢的程度有多接近,常用的度量有余弦相似度和皮尔逊相关系数。与目标用户相似度最高的若干个用户构成邻居集合,邻居看过而目标用户没看过的物品,按相似度加权求和得到预测评分,再排序取前 N 个作为推荐结果。
也就是:先有历史评分,再把评分组织成矩阵,接着算出相似度并选出邻居,最后由邻居的评分推断目标用户对未看物品的评分并排序出推荐列表。这条链路上每一步都有不同的实现方式,UserCF 与 ItemCF 的差别出现在「算谁的相似度」这一步,ALS 的差别出现在「怎么填空」这一步。
5.3.2 UserCF 与 ItemCF 的区别与取舍
基于用户的协同过滤(UserCF)找的是相似用户。给定一个目标用户,先算出他与其他所有用户的相似度,取相似度最高的若干人作为邻居,再把邻居评价高、而目标用户还没看过的物品推荐给他。它的出发点是「和你有相同口味的人喜欢的东西,你大概率也喜欢」。
基于物品的协同过滤(ItemCF)找的是相似物品。给定一个用户已经打过分的物品,先算出与它最相似的其他物品,再把那些相似物品推荐给该用户。它的出发点是「你喜欢的这部片子,和它相似的那些片子你大概率也喜欢」。
两者的取舍依据是数据规模和变化速度。UserCF 适合用户数量相对少、物品数量多且时效性强的场景,例如新闻推荐,因为新闻更新快而用户群相对稳定,用户相似度矩阵不会频繁失效。ItemCF 适合物品数量少而相对稳定、用户数量很大的场景,例如电影、图书、电商商品推荐,因为物品之间的相似关系比用户之间的关系更稳定,计算出来的相似度矩阵可以长期复用。
5.3.3 基于模型的协同过滤与 ALS
前面两类方法都属于基于邻域的方法,它们需要现算相似度,在稀疏矩阵上效果受限。基于模型的协同过滤换个思路:先用历史评分训练出一个参数化模型,预测时直接用模型计算,不再临时找邻居。
这一类里最有代表性的就是矩阵分解,而 MLlib 提供的实现是 ALS,即交替最小二乘法。它的做法是把原本的评分矩阵 R 近似成两个小矩阵的乘积:一个用户因子矩阵,行数等于用户数,列数等于 rank;一个物品因子矩阵,行数等于物品数,列数也是 rank。两个矩阵相乘后得到的数值就是预测评分。因为 R 里大部分格子是空的,直接求最优解没有闭式解,ALS 采取的是一种交替求解策略:先随机固定物品因子矩阵,用最小二乘法解出用户因子矩阵;再固定刚刚得到的用户因子矩阵,解出物品因子矩阵;如此反复迭代,直到误差收敛或达到最大迭代次数。
ALS 会根据数据来源区分两种反馈。显式反馈指用户主动给出的评分,比如 1 到 5 分的打分,ALS.train 处理的就是这类数据;隐式反馈指从用户行为中间接推断出来的偏好,比如点击、观看、购买,行为本身没有分值,只能表示「发生过」以及发生的次数,ALS.trainImplicit 处理的是这类数据,并额外用 alpha 参数控制偏好行为的强度基准。
ALS 有六个常用参数,含义与默认值如下。
| 参数 | 含义 | 默认值 |
|---|---|---|
rank | 模型中隐语义因子的个数 | 10 |
maxIter | 迭代的次数 | 10 |
regParam | ALS 的正则化参数 | 1.0 |
implicitPrefs | 决定用显性反馈 ALS 的版本,还是用适用隐性反馈数据集的版本 | false,即用显性反馈 |
alpha | 针对于隐性反馈 ALS 版本的参数,决定偏好行为强度的基准 | 1.0 |
nonnegative | 决定是否对最小二乘法使用非负的限制 | false |
正式训练前,还要把数据切成训练集和测试集:训练集用来求解因子矩阵,测试集只保存真实评分,用来计算 RMSE。RMSE 是均方根误差,计算方式是先求预测评分与真实评分之差的平方,取平均后再开方,数值越小说明模型预测越准。
5.3.4 准备评分数据并启动 spark-shell
这一步先确认数据文件就位,再把它放进 HDFS,最后启动交互式环境。在终端执行:
# 在任意目录下执行,进入 Spark 安装目录
cd /usr/local/spark
# 查看评分数据文件是否存在
ls -l ratings.dat
应当能看到文件名列表里有 ratings.dat。
ratings.dat接着把数据上传到 HDFS,放在 /input_spark/ 目录下:
# 在任意目录下执行,HDFS 命令不依赖本地工作目录
cd /usr/local/spark
hdfs dfs -mkdir -p /input_spark
hdfs dfs -put ratings.dat /input_spark/
hdfs dfs -ls /input_spark
上传成功时最后一条命令会列出刚放进去的文件:
Found 1 items
-rw-r--r--   3 hadoop supergroup     /input_spark/ratings.dat
再抽查前几行,确认分隔符和字段顺序与读取代码一致。MovieLens 的 ratings.dat 用双冒号分隔,四个字段依次是用户 id、电影 id、评分、时间戳:
# 在任意目录下执行,从 HDFS 读文件头部
hdfs dfs -cat /input_spark/ratings.dat | head -3
1::1193::5::978300760
1::661::3::978302109
1::914::3::978301968字段顺序与分隔符必须和后面 split("::") 的写法一一对应,否则会在类型转换处报错。如果文件已经在 HDFS 里,重复执行 hdfs dfs -put 会提示文件已存在,此时用 hdfs dfs -rm -r /input_spark/ratings.dat 删掉再传,或加 -f 覆盖。
数据就位后启动 spark-shell:
# 在 Spark 的 bin 目录下执行
cd /usr/local/spark/bin
./spark-shell
启动完成后终端进入 Scala 交互界面,关键提示如下:
Spark context available as 'sc' (master = local[*], app id = local-...).
Spark session available as 'spark'.
scala>
出现 scala> 就说明下一步的代码可以直接逐段粘贴执行。启动时若先刷出大量 WARN 日志属于正常现象,只要最后落在 scala> 提示符上即可继续。
5.3.5 在 spark-shell 里跑 ALS 显式模型与隐式模型
以下代码全部在 scala> 提示符后逐段输入。段与段之间空一行,输入的续行提示符是 |,整段表达式写完再按回车执行。
先导入 ALS、Rating 与评估类。Rating 是 MLlib 里表示一条评分记录的类型,字段依次为用户 id、物品 id、评分、时间戳:
// 在 spark-shell 的 scala> 提示符后执行
import org.apache.spark.mllib.recommendation.ALS
import org.apache.spark.mllib.recommendation.Rating
import org.apache.spark.mllib.evaluation.RegressionMetrics
再按数据结构创建读取规范,把 HDFS 上的文本行解析成 Rating:
// 在 spark-shell 的 scala> 提示符后执行
val rawRatings = sc.textFile("/input_spark/ratings.dat")
val ratings = rawRatings.map { line =>
  val fields = line.split("::")
  Rating(fields(0).toInt, fields(1).toInt, fields(2).toDouble, fields(3).toLong)
}
ratings.count()
count() 会触发一次实际计算,结果形如 res0: Long = …,返回记录总条数。如果这里报数字格式异常,说明 split 的分隔符写错了。
把数据按 8:2 随机切成训练集与测试集:
// 在 spark-shell 的 scala> 提示符后执行
val Array(training, test) = ratings.randomSplit(Array(0.8, 0.2))
用默认的 ALS.train() 方法训练显式反馈模型。该方法默认 implicitPrefs 为 false,即使用显性反馈数据。三个位置参数分别是训练数据、隐语义因子个数、迭代次数:
// 在 spark-shell 的 scala> 提示符后执行
val rank = 10
val maxIter = 10
val model = ALS.train(training, rank, maxIter)
训练结束返回一个 MatrixFactorizationModel,它可以用 predict 对任意「用户—物品」对给出预测评分,也可以用 recommendProducts 对指定用户给出 Top-N 推荐。
接着训练隐式反馈模型。ALS.trainImplicit 的第四个位置参数是 alpha,用来决定偏好行为强度的基准,这里取默认量级 1.0:
// 在 spark-shell 的 scala> 提示符后执行
val alpha = 1.0
val implicitModel = ALS.trainImplicit(training, rank, maxIter, alpha)
对指定用户取 20 条推荐结果,打印出来的每行形如 Rating(用户 id, 电影 id, 预测评分):
// 在 spark-shell 的 scala> 提示符后执行
val top20 = model.recommendProducts(1, 20)
top20.foreach(println)
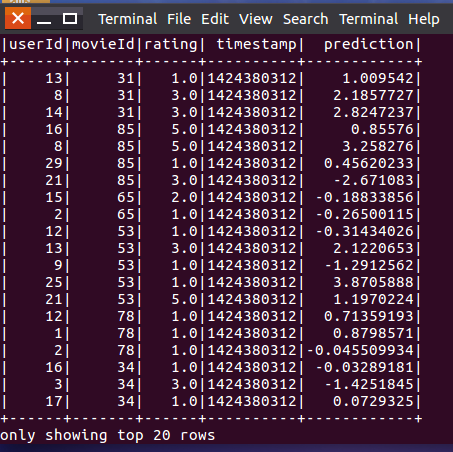
显式模型针对指定用户输出的 Top 20 推荐结果表如下,表里的列依次是用户 id、电影 id、真实评分与时间戳、预测评分。
5.3.6 计算 RMSE 并输出 Top-N 推荐结果
模型训练完只有分数高低是不够的,还要用测试集量化它的预测偏差。先把测试集里的真实评分与模型对同一批「用户—物品」对给出的预测评分拼到一起:
// 在 spark-shell 的 scala> 提示符后执行
val testPairs = test.map(r => (r.userId, r.movieId))
val predictions = model.predict(testPairs)
val predictionAndLabels = predictions
  .map(r => ((r.user, r.product), r.rating))
  .join(test.map(r => ((r.userId, r.movieId), r.rating)))
  .map { case (_, (predicted, actual)) => (predicted, actual) }
用 RegressionMetrics 计算均方根误差,并打印显式模型的结果:
// 在 spark-shell 的 scala> 提示符后执行
val metrics = new RegressionMetrics(predictionAndLabels)
println("explicit:Root-mean-square error = " + metrics.rootMeanSquaredError)
输出为:
explicit:Root-mean-square error = 1.7762182125089795对隐式模型重复同样的评估过程:
// 在 spark-shell 的 scala> 提示符后执行
val implicitPredictions = implicitModel.predict(testPairs)
val implicitPredictionAndLabels = implicitPredictions
  .map(r => ((r.user, r.product), r.rating))
  .join(test.map(r => ((r.userId, r.movieId), r.rating)))
  .map { case (_, (predicted, actual)) => (predicted, actual) }
val implicitMetrics = new RegressionMetrics(implicitPredictionAndLabels)
println("Implicit:Root-mean-square error = " + implicitMetrics.rootMeanSquaredError)
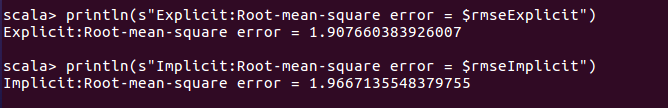
两个模型各输出一行 RMSE,显式模型约 1.78,隐式模型约 1.97:
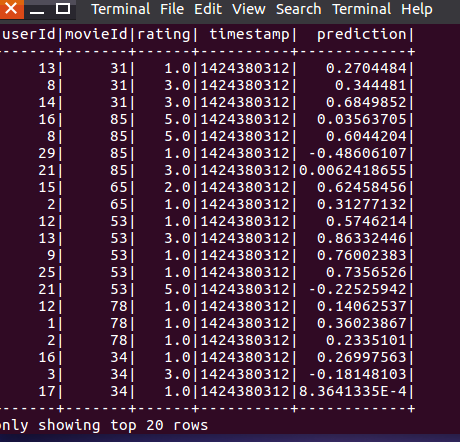
最后输出 Top-N 推荐结果。推荐结果表把用户 id、电影 id、真实评分与时间戳、预测评分并列,方便对照预测与实际的差距:
对更多用户批量取 Top-N 时,可以循环调用 recommendProducts,把每个用户的推荐列表依次打印:
// 在 spark-shell 的 scala> 提示符后执行
val users = test.map(_.userId).distinct().take(5)
users.foreach { u =>
  println("=== user " + u + " ===")
  model.recommendProducts(u, 20).foreach(println)
}
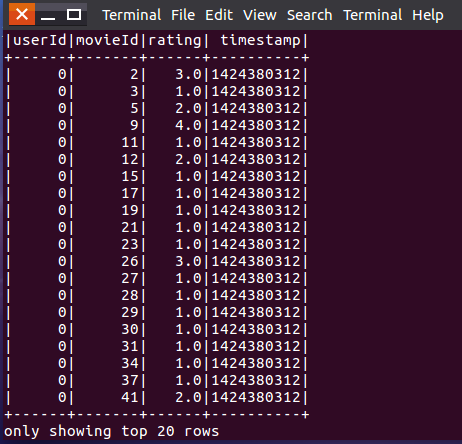
批量输出后同样可以得到多张 Top 20 结果表:
5.4 结果验证
逐条核对,全部通过才算本章完成。
hdfs dfs -ls /input_spark的输出里出现/input_spark/ratings.dat,说明数据已进入 HDFS。hdfs dfs -cat /input_spark/ratings.dat | head -3每行都能按::切出四个字段,且第三、四个字段分别为数字与整数时间戳。spark-shell启动后终端停在scala>提示符,且提示行里出现Spark context available as 'sc'。ratings.count()返回一个大于 0 的整数,说明评分记录被正确解析成Rating。- 终端打印
explicit:Root-mean-square error = 1.7762182125089795,显式模型的 RMSE 小于 2。 - 终端打印
Implicit:Root-mean-square error = 1.966715548379755,隐式模型的 RMSE 小于 2。 - 显式模型的 RMSE 小于隐式模型,说明在本数据集上按显式评分尺度评估时显式模型更贴合。
model.recommendProducts(1, 20)返回 20 条记录,每行格式为Rating(用户 id, 电影 id, 预测评分)。- Top-N 结果表中,同一用户推荐出的电影 id 互不重复,不再包含该用户已评分过的电影。
5.5 常见问题
| 现象 | 原因 | 处理 |
|---|---|---|
java.io.FileNotFoundException: File /input_spark/ratings.dat does not exist. | 数据只放在本地 /usr/local/spark/,没有上传到 HDFS,或路径写错 | 执行 hdfs dfs -mkdir -p /input_spark 后重新 hdfs dfs -put ratings.dat /input_spark/,再用 hdfs dfs -ls /input_spark 确认 |
put: File /input_spark/ratings.dat already exists | HDFS 上已有同名文件,put 默认不覆盖 | 先 hdfs dfs -rm -r /input_spark/ratings.dat,或改用在文件前加 -f 的覆盖写法 |
java.net.ConnectException: Call From hadoop to localhost:9000 failed on connection exception | HDFS 没有启动,或 core-site.xml 里的地址与实际监听的地址不一致 | 先执行 start-dfs.sh,用 jps 确认 NameNode、DataNode 已启动,再核对 HDFS 端口配置 |
java.lang.NumberFormatException: For input string: "1::1193::5::978300760" | split 的分隔符写成了单冒号或其他字符,切不出四个字段 | 把分隔符改成 "::",先用 take(1) 打印切分后的数组确认字段数 |
value trainImplicit is not a member of object org.apache.spark.mllib.recommendation.ALS | 参数个数与版本不匹配,或类名拼写有误 | 核对 ALS.trainImplicit 的调用形式,确认传入了训练数据、rank、迭代次数与 alpha |
java.lang.OutOfMemoryError: Java heap space | 单机内存不足,或 spark-shell 默认堆内存偏小 | 重启时用 ./spark-shell --driver-memory 2g 提高驱动内存,并减少同时缓存的 RDD 数量 |
[Stage 0:> (0 + 1) / 1] 长时间停在同一进度不动 | 任务仍在计算,或资源被其他进程占用 | 等待数分钟;若无变化则用 Ctrl+C 中断,检查集群资源与 spark-shell 的 master 设置后重跑 |