电影推荐系统(基础版)的实现过程
7.1 这是什么
本章把前面几章单独练过的东西串成一条完整链路:用一份公开的电影评分数据集训练推荐模型,再把推荐结果通过网页展示出来。产出是一个能跑在本机的电影推荐系统基础版,由三部分组成——HDFS 上的原始数据集、一段用 Scala 写的 Spark ALS 程序、一个用 Node.js 写的展示页面。
数据来自 MovieLens 数据集,它是推荐系统领域被反复使用的公开评分数据集,本章用到的三份文件分别是:ratings.dat 记录用户对电影的评分,每行四个字段,用户编号、电影编号、评分、评分时间戳;movies.dat 是电影目录,每行三个字段,电影编号、电影名称、电影类别;personalRatings.txt 是待推荐用户自己给出的几条评分,模型要针对这个人算推荐。三个文件的字段都用双冒号 :: 分隔,这是 MovieLens 早期版本的固定格式。
技术名词按出现顺序解释一遍。HDFS 是分布式文件系统,数据被切成块分散在多台机器的磁盘上,并保留多副本,本章用它存放原始数据集。ALS 是交替最小二乘法,协同过滤里用矩阵分解做推荐的经典算法,第 5 章已经用它算过一遍推荐结果,本章直接把它用进完整流程。Top-N 推荐指模型对某个用户未看过的电影逐个打分,按分数从高到低取前 N 部作为推荐清单。MSE 是均方误差,把预测评分与真实评分的差值平方后取平均;对它开平方就是 RMSE(均方根误差),单位和评分一致,所以更好读数;本章用 RMSE 衡量模型好坏。Maven 是 Java 项目的构建工具,项目根目录下的 pom.xml 声明依赖包和打包插件,执行 mvn package 就能把 Scala 源码连同依赖一起打成可提交的 JAR 包。spark-submit 是 Spark 提供的作业提交命令,把 JAR 包、主类和运行参数一起交给 Spark 执行。Express 是 Node.js 上最常用的 Web 框架,用它可以按 URL 路径把请求分发给不同的处理函数,这种分发规则叫路由。Jade 是 Express 支持的模板引擎,用缩进代替 HTML 标签写页面,写完由服务端渲染成 HTML 返回给浏览器。
在整体流程里,本章处在收尾位置:前面依赖第 5 章的 ALS 算法原理、第 6 章的 Node.js 与 Express + Jade 用法、第 2.3.4 节的 Kettle 上传操作;后面第 8 章的升级版系统会在这条链路的基础上补上数据库和多页面站点,所以本章的每一步都要先跑通。
7.2 前置条件
开始动手前逐条核对,缺一项后面的步骤都会卡住。
- Hadoop 已经在虚拟机里启动,执行
jps能看到NameNode、DataNode、ResourceManager、NodeManager四个进程。 - Spark 已经安装并可用,执行
spark-shell能进入scala>提示符,中途不报ClassNotFoundException。 - Maven 已经安装,执行
mvn -v能打印出 Maven 与 JDK 版本号。 - Node.js 与 npm 已经安装,执行
node -v和npm -v都能打印版本号。 - MovieLens 数据集已经准备好,本地目录下有
ratings.dat、movies.dat两个文件,另外自己准备一份personalRatings.txt作为待推荐用户的评分。 - 虚拟机可以访问外网。首次执行 Maven 打包要联网下载依赖包,要等几分钟;如果之前配过阿里云镜像,速度会明显快一些。
- 已经掌握少量前置知识:会用
vim编辑文件并保存退出,会在终端里cd到指定目录,看得懂 Scala 的val与匿名函数=>写法。
7.3 操作步骤
7.3.1 理清整体数据分析过程
这一小步不执行命令,先把整条链路想清楚,后面每一步就知道自己在做什么。基础版系统一共四段:第一段把三份数据文件从本地上传进 HDFS 输入目录,第二段用 Spark 读这份数据、训练 ALS 模型并算出推荐结果,第三段把推荐结果打印出来,第四段在 Node.js 页面里把这批结果渲染给用户看。
容易踩的地方:Spark 只从 HDFS 读 ratings.dat 和 movies.dat,personalRatings.txt 放在 Linux 本地文件系统里,可以不往 HDFS 传,这一点在 7.3.4 节的参数位置会有体现。
7.3.2 把数据集加载到 HDFS 中
参照第 2.3.4 节「使用 Kettle 把数据加载到 HDFS 中」的做法,用 Kettle 的「Hadoop File Output」步骤把三份文件上传到 HDFS 的 /input_spark 目录,也可以直接用 HDFS Shell 的 put 命令完成,命令方式如下。
# 执行目录:/usr/local/hadoop
cd /usr/local/hadoop
bin/hdfs dfs -mkdir -p /input_spark
bin/hdfs dfs -put /home/hadoop/下载/ratings.dat /input_spark
bin/hdfs dfs -put /home/hadoop/下载/movies.dat /input_spark
bin/hdfs dfs -put /home/hadoop/下载/personalRatings.txt /input_spark
上传完成后列出目录,确认三个文件都在,每一行末尾是文件大小。
# 执行目录:/usr/local/hadoop
cd /usr/local/hadoop
bin/hdfs dfs -ls /input_spark
接着查看 ratings.dat 的内容,验证数据行格式是否为双冒号分隔的四个字段。
# 执行目录:/usr/local/hadoop
cd /usr/local/hadoop
bin/hdfs dfs -cat /input_spark/ratings.dat
输出形如下面几行。
1::1::5::978300760
1::2::3::978302109
2::1::1::978300761
2::2::2::978302102
2::3::3::978301963
movies.dat 用同样方式查看,末尾的类别字段内部用竖线 | 分隔多个类别。
# 执行目录:/usr/local/hadoop
cd /usr/local/hadoop
bin/hdfs dfs -cat /input_spark/movies.dat | head -5
输出形如 1::Toy Story (1995)::Animation|Children's|Comedy。
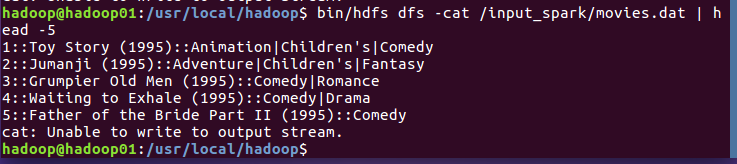
容易踩的地方:hdfs dfs -cat 接 head 时,管道读满指定行数后提前关闭,终端可能多打一行 cat: Unable to write to output stream.,这是管道退出引起的,不是数据有问题。
7.3.3 编写 Spark 程序实现电影推荐
这一小步写 Scala 程序。Node.js 的项目文件默认放在 ~/nodejsAPP,Scala 项目也统一建在这里,先建目录结构。
# 执行目录:用户主目录
cd ~/nodejsAPP
mkdir recommendApp
cd recommendApp
mkdir src
mkdir src/main
mkdir src/main/scala
cd src/main/scala
然后在 ~/nodejsAPP/recommendApp/src/main/scala 目录下新建源码文件。
# 执行目录:~/nodejsAPP/recommendApp/src/main/scala
cd ~/nodejsAPP/recommendApp/src/main/scala
vim MovieLensALS.scala把下面的完整源码复制进去并保存。程序分成三段:main 负责读数据、切分样本、训练并输出推荐;computeRmse 负责算均方根误差;loadRatings 负责读待推荐用户的评分文件。
package recommend

import java.io.File
import scala.io.Source
import org.apache.log4j.{ Level, Logger }
import org.apache.spark.SparkConf
import org.apache.spark.SparkContext
import org.apache.spark.SparkContext._
import org.apache.spark.rdd._
import org.apache.spark.mllib.recommendation.ALS
import org.apache.spark.mllib.recommendation.Rating
import org.apache.spark.mllib.recommendation.MatrixFactorizationModel

object MovieLensALS {
  def main(args: Array[String]) {
    // 屏蔽不必要的日志显示在终端上
    Logger.getLogger("org.apache.spark").setLevel(Level.ERROR)
    Logger.getLogger("org.eclipse.jetty.server").setLevel(Level.OFF)
    if (args.length != 5) {
      println("Usage: /usr/local/spark/bin/spark-submit --class recommend.MovieLensALS " +
        "Spark_Recommend.jar movieLensHomeDir personalRatingsFile bestRank bestLambda bestNumiter")
      sys.exit(1)
    }
    // 设置运行环境
    val conf = new SparkConf().setAppName("MovieLensALS").setMaster("local[1]")
    val sc = new SparkContext(conf)
    // 装载参数二,即用户评分,该评分由评分器生成
    val myRatings = loadRatings(args(1))
    val myRatingsRDD = sc.parallelize(myRatings, 1)
    // 样本数据目录
    val movieLensHomeDir = args(0)
    // 装载样本评分数据,其中最后一列 Timestamp 取除 10 的余数作为 key,Rating 为值,即 (Int,Rating)
    // ratings.dat 原始数据:用户编号、电影编号、评分、评分时间戳
    val ratings = sc.textFile(new File(movieLensHomeDir, "ratings.dat").toString).map { line =>
      val fields = line.split("::")
      (fields(3).toLong % 10, Rating(fields(0).toInt, fields(1).toInt, fields(2).toDouble))
    }
    // 装载电影目录对照表(电影 ID -> 电影标题)
    // movies.dat 原始数据:电影编号、电影名称、电影类别
    val movies = sc.textFile(new File(movieLensHomeDir, "movies.dat").toString).map { line =>
      val fields = line.split("::")
      (fields(0).toInt, fields(1).toString())
    }.collect().toMap
    val numRatings = ratings.count()
    val numUsers = ratings.map(_._2.user).distinct().count()
    val numMovies = ratings.map(_._2.product).distinct().count()
    // 将样本评分表以 key 值切分成 3 个部分,分别用于训练 (60%,并加入用户评分)、校验 (20%) 和测试 (20%)
    // 该数据在计算过程中要多次应用到,所以 cache 到内存
    val numPartitions = 4
    // training 训练样本数据
    val training = ratings.filter(x => x._1 < 6) // 取评分时间除 10 的余数后值小于 6 的作为训练样本
      .values
      .union(myRatingsRDD) // 注意 ratings 是 (Int,Rating),取 value 即可
      .repartition(numPartitions)
      .cache()
    // validation 校验样本数据
    val validation = ratings.filter(x => x._1 >= 6 && x._1 < 8) // 余数大于等于 6 且小于 8 的作为校验样本
      .values
      .repartition(numPartitions)
      .cache()
    // test 测试样本数据
    val test = ratings.filter(x => x._1 >= 8).values.cache() // 余数大于等于 8 的作为测试样本
    val numTraining = training.count()
    val numValidation = validation.count()
    val numTest = test.count()
    // 训练不同参数下的模型,并在校验集中验证,获取最佳参数下的模型
    val ranks = List(8, 12) // 模型中隐语义因子的个数
    val lambdas = List(0.1, 10.0) // 是 ALS 的正则化参数
    val numIters = List(10, 20) // 迭代次数
    var bestModel: Option[MatrixFactorizationModel] = None // 最好的模型
    var bestValidationRmse = Double.MaxValue // 最好的校验均方根误差
    var bestRank = args(2).toInt // 最好的隐语义因子的个数
    var bestLambda = args(3).toDouble // 最好的 ALS 正则化参数
    var bestNumIter = args(4).toInt // 最好的迭代次数
    for (rank <- ranks; lambda <- lambdas; numIter <- numIters) {
      val model = ALS.train(training, rank, numIter, lambda) // 训练样本、隐语义因子个数、迭代次数、正则化参数
      val validationRmse = computeRmse(model, validation, numValidation) // 校验模型结果
      if (validationRmse < bestValidationRmse) {
        bestModel = Some(model)
        bestValidationRmse = validationRmse
        bestRank = rank
        bestLambda = lambda
        bestNumIter = numIter
      }
    }
    // 用最佳模型预测测试集的评分,并计算和实际评分之间的均方根误差
    val testRmse = computeRmse(bestModel.get, test, numTest)
    // 创建一个 naïve baseline 和最好的模型比较
    val meanRating = training.union(validation).map(_.rating).mean
    val baselineRmse =
      math.sqrt(test.map(x => (meanRating - x.rating) * (meanRating - x.rating)).mean)
    // 提高了 baseline 的最佳模型
    val improvement = (baselineRmse - testRmse) / baselineRmse * 100
    println("The best model  improves the baseline by " + "%1.2f".format(improvement) + "%.")
    // 推荐前 5 部最感兴趣的电影,注意要剔除用户已经评分的电影
    val myRatedMovieIds = myRatings.map(_.product).toSet
    val candidates = sc.parallelize(movies.keys.filter(!myRatedMovieIds.contains(_)).toSeq)
    val recommendations = bestModel.get
      .predict(candidates.map((1, _)))
      .collect()
      .sortBy(-_.rating)
      .take(5)
    println("Movies recommended for you(用户ID:推荐电影ID:推荐分数:推荐电影名称):")
    recommendations.foreach { r =>
      println( r.user + ":"+ r.product + ":"+  r.rating+":" + movies(r.product))
    }
    // 依次给用户 2、3、4 算推荐,写法和上面完全相同,只把 candidates.map((1, _)) 里的 1 换成对应编号
    sc.stop()
  }
  /**  校验集预测数据和实际数据之间的均方根误差 **/
  def computeRmse(model: MatrixFactorizationModel, data: RDD[Rating], n: Long): Double = {
    val predictions = model.predict(data.map(x => (x.user, x.product))) // 调用预测的函数
    // 将真实评分数据集与预测评分数据集进行合并。这里 Join 类似 SQL 的 inner join,只返回两边配对成功的记录。
    val predictionsAndRatings = predictions.map(x => ((x.user, x.product), x.rating))
      .join(data.map(x => ((x.user, x.product), x.rating)))
      .values
    // 计算均方差
    math.sqrt(predictionsAndRatings.map(x => (x._1 - x._2) * (x._1 - x._2)).reduce(_ + _) / n)
  }
  /** 装载用户评分文件 **/
  def loadRatings(path: String): Seq[Rating] = {
    val lines = Source.fromFile(path).getLines()
    val ratings = lines.map { line =>
      val fields = line.split("::")
      Rating(fields(0).toInt, fields(1).toInt, fields(2).toDouble)
    }.filter(_.rating > 0.0)
    if (ratings.isEmpty) {
      sys.error("No ratings provided.")
    } else {
      ratings.toSeq
    }
  }
}
程序里几处关键逻辑单独说明一下。
args.length != 5:主程序要求正好 5 个参数,少传或多传就直接打印用法并sys.exit(1)退出。new SparkConf().setAppName("MovieLensALS").setMaster("local[1]"):单机单线程跑,local[1]表示只用一个本地线程。fields(3).toLong % 10:把评分时间戳除以 10 取余数,得到一个 0 到 9 的整数当 key,再按这个 key 把样本切成训练、校验、测试三份。用时间戳而不是随机数切分,是为了让切分结果在同一份数据上可以复现。ratings.filter(x => x._1 < 6):余数小于 6 的进训练集,占 60%;x._1 >= 6 && x._1 < 8的进校验集,占 20%;x._1 >= 8的进测试集,剩下的 20%。union(myRatingsRDD):把待推荐用户的评分并进训练集,模型才会把这个用户当成训练数据里存在的人,才能给他算推荐。ALS.train(training, rank, numIter, lambda):三个参数分别是隐语义因子个数、迭代次数、正则化参数。程序用for循环把ranks、lambdas、numIters三组取值组合起来各训练一次,取校验集 RMSE 最小的那个当最佳模型。computeRmse:先用predict算出预测评分,再和真实评分按(用户, 电影)做join,只有两边都有的记录才配对成功,最后按均方误差公式开平方。myRatedMovieIds:待推荐用户已经评过分的电影要从候选集里剔除,否则会推荐他已经看过的片子。
7.3.4 用 Maven 打包并提交到 Spark 运行
这一小步先把项目打成 JAR 包,再提交执行。在 ~/nodejsAPP/recommendApp 目录下新建 pom.xml,要和 src 目录平级。
# 执行目录:~/nodejsAPP/recommendApp
cd ~/nodejsAPP/recommendApp
vim pom.xml
pom.xml 声明构件坐标、依赖包和 Scala 编译插件。项目里的 Spark 版本按自己的环境改,这里用的是 2.4.0。
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <groupId>org.example</groupId>
    <artifactId>Spark_Recommend</artifactId>
    <version>1.0-SNAPSHOT</version>
    <properties>
        <spark.version>2.4.0</spark.version>
    </properties>
    <repositories>
        <repository>
            <id>alimaven</id>
            <name>aliyun maven</name>
            <url>http://maven.aliyun.com/nexus/content/groups/public/</url>
        </repository>
    </repositories>
    <dependencies>
        <dependency><groupId>log4j</groupId><artifactId>log4j</artifactId><version>1.2.17</version></dependency>
        <dependency><groupId>com.google.guava</groupId><artifactId>guava</artifactId><version>27.0-jre</version></dependency>
        <dependency><groupId>org.apache.spark</groupId><artifactId>spark-mllib_2.11</artifactId><version>${spark.version}</version></dependency>
        <dependency><groupId>org.apache.spark</groupId><artifactId>spark-hive_2.11</artifactId><version>${spark.version}</version></dependency>
        <dependency>
            <groupId>org.apache.spark</groupId><artifactId>spark-core_2.11</artifactId><version>${spark.version}</version>
            <exclusions><exclusion><groupId>com.google.guava</groupId><artifactId>guava</artifactId></exclusion></exclusions>
        </dependency>
        <dependency><groupId>mysql</groupId><artifactId>mysql-connector-java</artifactId><version>5.1.46</version></dependency>
        <dependency><groupId>org.apache.hadoop</groupId><artifactId>hadoop-yarn-common</artifactId><version>3.1.3</version></dependency>
    </dependencies>
    <build>
        <plugins>
            <plugin>
                <groupId>net.alchim31.maven</groupId>
                <artifactId>scala-maven-plugin</artifactId>
                <version>3.2.0</version>
                <executions>
                    <execution>
                        <id>compile-scala</id><phase>compile</phase>
                        <goals><goal>add-source</goal><goal>compile</goal></goals>
                    </execution>
                </executions>
                <configuration>
                    <scalaVersion>2.11.12</scalaVersion>
                </configuration>
            </plugin>
        </plugins>
    </build>
</project>
scala-maven-plugin 这一段是必需的:Maven 默认只编译 src/main/java 下的 Java 源码,add-source 加上 compile 两个目标才会把 src/main/scala 里的 Scala 文件也编译进来,少了这段打包出来的 JAR 里不会有 MovieLensALS.class。
在当前目录执行打包,首次执行要联网下载依赖,需要几分钟;成功后目录下会多出 target 子目录,里面生成 Spark_Recommend-1.0-SNAPSHOT.jar。
# 执行目录:~/nodejsAPP/recommendApp
cd ~/nodejsAPP/recommendApp
mvn package
ls target/*.jar
接着把 JAR 包提交到 Spark 运行,切到 Spark 安装目录再调用 spark-submit。
# 执行目录:/usr/local/spark
cd /usr/local/spark
./bin/spark-submit --class recommend.MovieLensALS \
  ~/nodejsAPP/recommendApp/target/Spark_Recommend-1.0-SNAPSHOT.jar \
  /input_spark ~/movie_recommend/personalRatings.dat 10 5 10
命令里 --class recommend.MovieLensALS 指定主类,与源码里的 package recommend 和 object MovieLensALS 对应;JAR 包之后跟的 5 个参数依次是:样本数据目录 /input_spark(HDFS 上的目录,里面有 ratings.dat 和 movies.dat)、待推荐用户评分文件路径(Linux 本地文件系统的路径,不放在 HDFS 中)、隐语义因子个数 10、ALS 正则化参数 5、迭代次数 10。运行过程中终端会刷出大量 Spark 日志,等日志停止刷动后,末尾会打印基准提升比例和各用户的推荐结果。
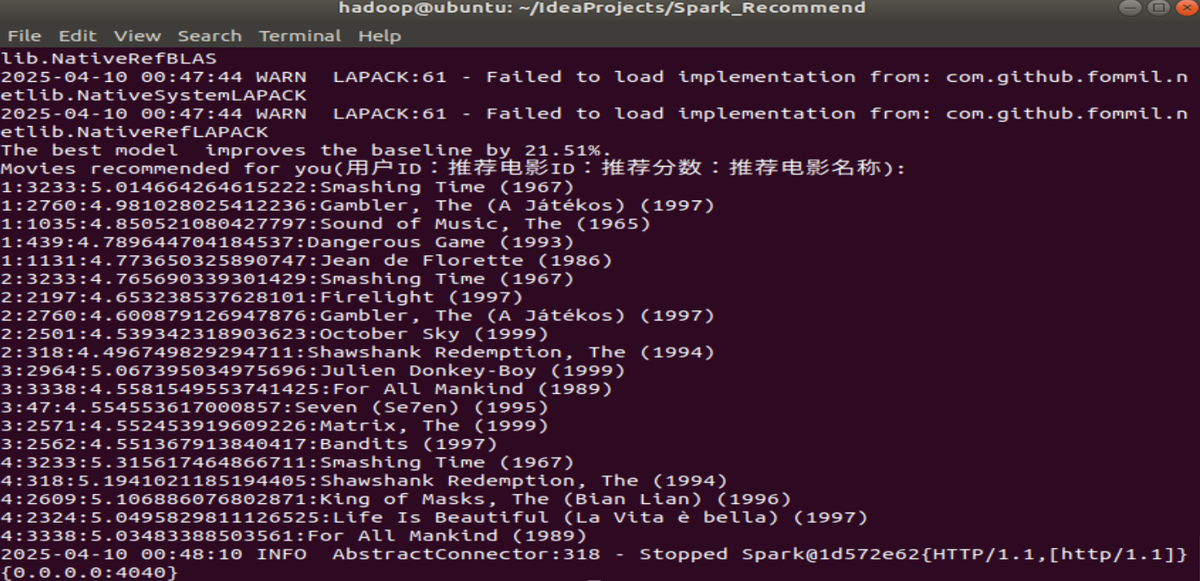
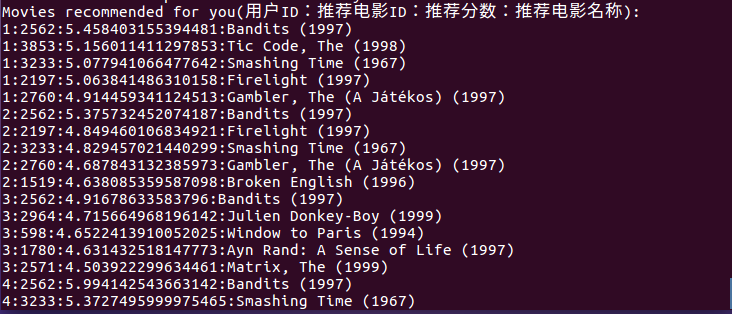
容易踩的地方:spark-submit 后面的 5 个参数顺序不能颠倒,第 2 个参数指向的文件在本地磁盘上,写成 HDFS 路径会读不到;~/movie_recommend/personalRatings.dat 的路径按自己机器上的实际位置改。
7.3.5 使用 Node.js 在网页中展现结果
这一小步把推荐结果搬进浏览器。在 ~/nodejsAPP 下新建 mysparkapp 项目并初始化,npm init 会逐项询问项目名称、版本、入口文件等信息,不想逐项填写就一直按回车接受默认值,答完会在目录下生成 package.json。
# 执行目录:~/nodejsAPP
cd ~/nodejsAPP
mkdir mysparkapp
cd mysparkapp
npm init
然后安装三个模块:Express 提供 Web 服务,Jade 是模板引擎,body-parser 用来解析表单 POST 上来的数据。--save 前面是两个英文短横线。
# 执行目录:~/nodejsAPP/mysparkapp
cd ~/nodejsAPP/mysparkapp
npm install express --save
npm install jade --save
npm install body-parser --save
安装完成后三个模块会出现在当前项目的 node_modules 目录下,同时写进 package.json 的依赖列表。Node.js 引用模块时会自动从 node_modules 里找,所以每个项目各装一份。
接着在 mysparkapp 目录里新建 index.js,它是整个网页应用的入口。
# 执行目录:~/nodejsAPP/mysparkapp
cd ~/nodejsAPP/mysparkapp
vim index.js
内容如下。
const express = require('express')
const bodyParser = require('body-parser')
const spawnSync = require('child_process').spawnSync
const app = express();

// 设置模板引擎
app.set('views','./views')
app.set('view engine','jade')
// 添加 body-parser 解析 post 过来的数据
app.use(bodyParser.urlencoded({extended: false}))
app.use(bodyParser.json())

app.get('/', function (req, res) {
  res.render('index', {title:'电影推荐系统', message:'大数据技术应用课程!', result:""})
})

app.post('/', function (req, res) {
  const path = req.body.path.trim() || '/input_spark'
  const myRatings = req.body.myRatings.trim() || '~/movie_recommend/personalRatings.dat'
  const bestRank = req.body.bestRank.trim() || 10
  const bestLambda = req.body.bestLambda.trim() || 5
  const bestNumIter = req.body.bestNumIter.trim() || 10
  let spark_submit = spawnSync('/usr/local/spark/bin/spark-submit',
    ['--class', 'recommend.MovieLensALS',
     '~/nodejsAPP/recommendApp/target/Spark_Recommend-1.0-SNAPSHOT.jar',
     path, myRatings, bestRank, bestLambda, bestNumIter],
    { shell: true, encoding: 'utf8' })
  res.render('index', {title: '电影推荐系统', message: '大数据技术应用课程!', result: spark_submit.stdout})
})

const server = app.listen(3000, function() {
  const host = server.address().address;
  const port = server.address().port;
  console.log('Example app listening at http://%s:%s', host, port);
});这段代码里,app.set('view engine','jade') 指定用 Jade 渲染模板;app.get('/', …) 处理浏览器直接访问首页的请求,只渲染一个空表单;app.post('/', …) 处理表单提交,把页面传上来的样本路径、评分文件路径、三个建模参数整理成数组,用 spawnSync 同步调用 spark-submit,等 Spark 跑完把标准输出塞进 result 再渲染回页面;app.listen(3000, …) 让 HTTP 服务器监听 3000 端口。
再建一个 views 目录,在里面放模板文件 index.jade。
# 执行目录:~/nodejsAPP/mysparkapp
cd ~/nodejsAPP/mysparkapp
mkdir views
cd views
vim index.jade
模板内容如下。Jade 用缩进表示层级,!= 表示这段内容按原样输出、不做 HTML 转义。
html
  head
    title!= title
  body
    h1!= message
    form(action='/', method='post')
      p 请输入建模的相关信息
      table(border=0)
        tr
          td 样本数据的路径(默认为/input_spark)
          td
            input(style='width:350px',placeholder='/input_spark',name='path')
        tr
          td 用户评分数据的路径(默认为~/movie_recommend/personalRatings.dat)
          td
            input(style='width:350px',placeholder='~/movie_recommend/personalRatings.dat',name='myRatings')
        tr
          td 隐语义因子个数(默认为10)
          td
            input(style='width:350px',placeholder='10',name='bestRank')
        tr
          td 正则化参数(默认为5)
          td
            input(style='width:350px',placeholder='5',name='bestLambda')
        tr
          td 迭代次数(默认为10)
          td
            input(style='width:350px',placeholder='10',name='bestNumIter')
      p
        input(type='submit', value='提交查询')
    pre!= result
input 的 name 要和 index.js 里读取的 req.body.path、req.body.myRatings 等字段一一对上,对不上就会一直走默认值。
保存退出后启动服务,终端会打印 Example app listening at http://:::3000。
# 执行目录:~/nodejsAPP/mysparkapp
cd ~/nodejsAPP/mysparkapp
node index.js
在虚拟机里打开浏览器访问 localhost:3000,页面出现五个输入框和一个「提交查询」按钮,点击按钮后 Node.js 去调用 Spark 作业,等几分钟页面刷新出推荐结果。
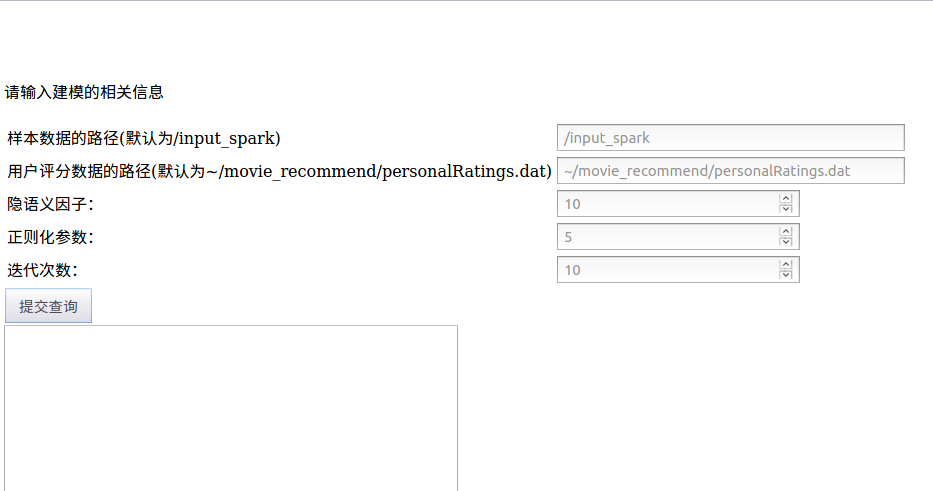
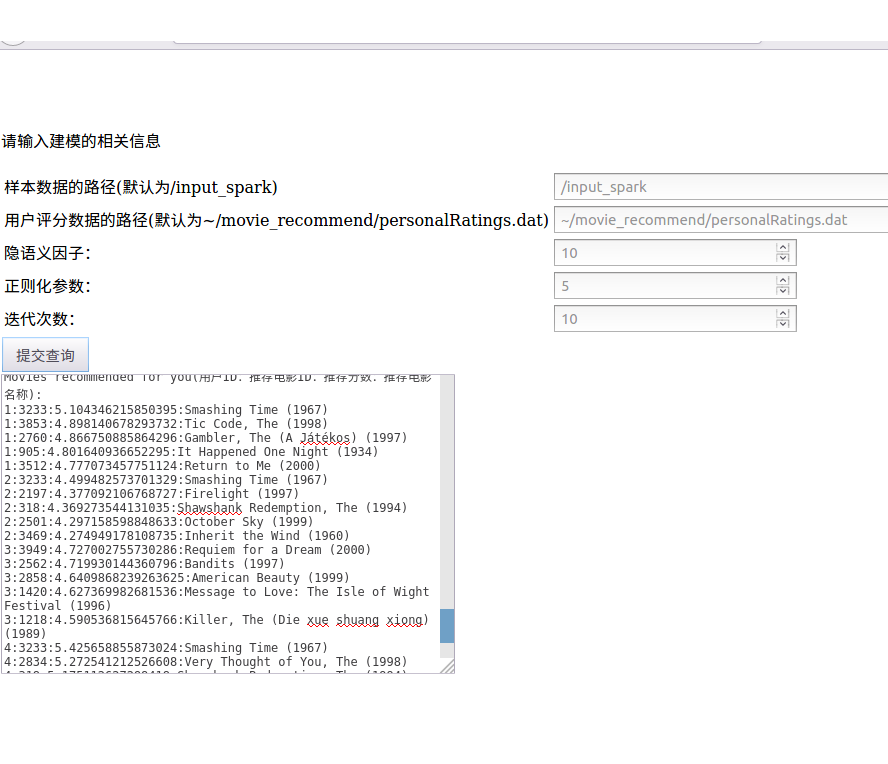
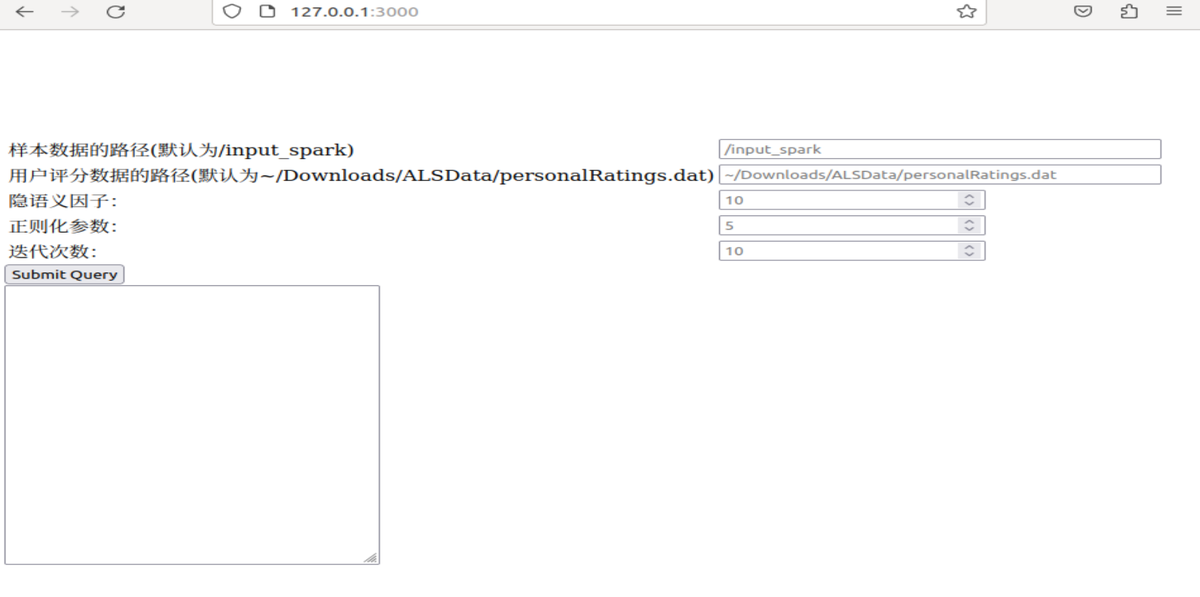
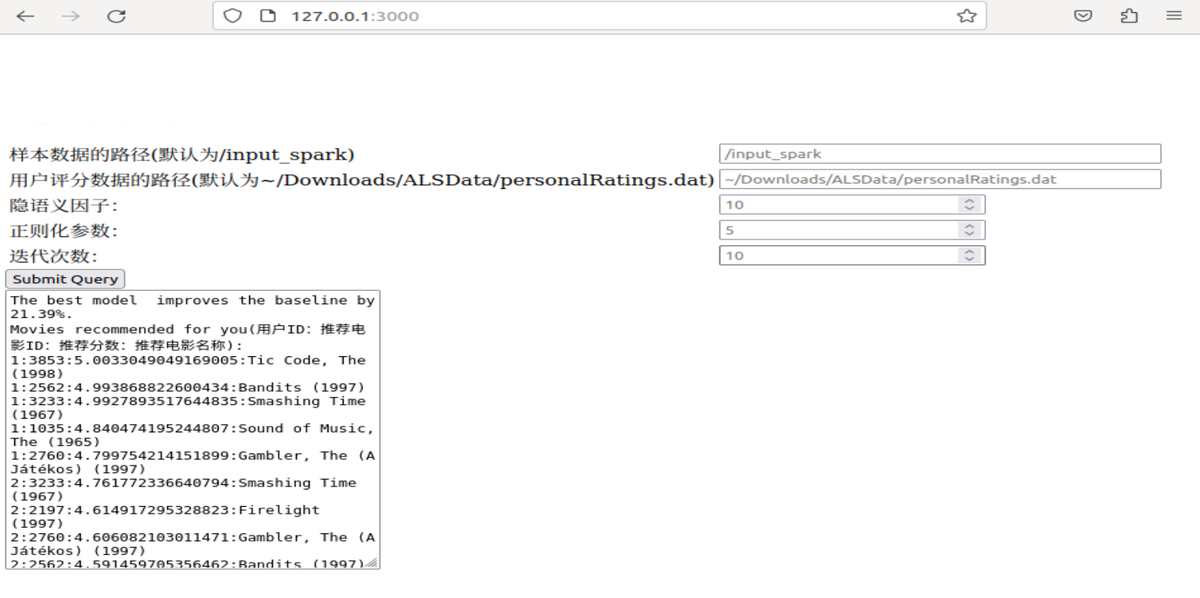
容易踩的地方:改了 index.js 或 index.jade 之后要按 Ctrl+C 停掉 node index.js 再重新启动,Node.js 不会自动加载改动;如果 3000 端口已被占用,控制台报 EADDRINUSE,换一个端口或先结束占用进程。
7.4 结果验证
逐条对照,每条都能明确判定通过或不通过。
- 执行
bin/hdfs dfs -ls /input_spark,输出中同时列出ratings.dat、movies.dat、personalRatings.txt三行。 - 执行
bin/hdfs dfs -cat /input_spark/ratings.dat后,输出行是1::1::5::978300760这种四字段、以双冒号分隔的格式,没有出现整行粘在一起的乱码。 ~/nodejsAPP/recommendApp/target/下有Spark_Recommend-1.0-SNAPSHOT.jar文件,且文件大小不为 0。spark-submit命令执行完毕后,终端最后打印出The best model improves the baseline by …%,百分数为正数,例如21.51%。- 同一个终端输出里能找到
Movies recommended for you(用户ID:推荐电影ID:推荐分数:推荐电影名称):这一行,后面每行形如1:3233:5.014664264615222:Smashing Time (1967),四段用冒号分隔,最后一段是电影名称而不是空白。 - 控制台出现
Example app listening at http://:::3000,且node index.js这个进程没有退出。 - 浏览器访问
http://localhost:3000能打开页面,页面上有「提交查询」按钮。 - 点击「提交查询」后页面重新加载,页面底部出现与终端同样格式的推荐结果文本。
7.5 常见问题
| 现象 | 原因 | 处理 | |
|---|---|---|---|
WARN LAPACK:61 - Failed to load implementation from: com.github.fommil.netlib.NativeSystemLAPACK | 系统里没有本地 BLAS/LAPACK 库,Spark 回退到纯 Java 实现 | 只是计算变慢,不影响结果,可以忽略;也可安装 netlib-java 依赖消除告警 | |
cat: Unable to write to output stream. | `hdfs dfs -cat … \ | head -5` 里管道读满指定行数后提前关闭,HDFS 写不进去 | 属于正常现象,与数据无关;要看完整内容就去掉管道 |
Input path does not exist: hdfs://…/input_spark/ratings.dat | 路径写错,或者 7.3.2 节的上传没有成功 | 先用 bin/hdfs dfs -ls /input_spark 确认文件真的在,再核对命令里的路径大小写 | |
提示找不到 recommend.MovieLensALS 或抛 java.lang.NoClassDefFoundError | pom.xml 里漏了 scala-maven-plugin,Scala 源码没被编译进 JAR | 补上 add-source 与 compile 两个 goal 后重新 mvn package | |
sys.error("No ratings provided.") | loadRatings 读到的评分全部被 filter(_.rating > 0.0) 过滤掉了,通常是评分文件为空或字段分隔符不是 :: | 打开该文件确认每行是三段、以 :: 分隔,且评分为大于 0 的数字 | |
Error: Cannot find module 'express' | 在错误的目录里启动了服务,或者模块没装上 | cd ~/nodejsAPP/mysparkapp 后再执行 node index.js;缺模块就重新 npm install express --save | |
Error: listen EADDRINUSE: address already in use :::3000 | 3000 端口已被别的进程占用,常见于上一次 node index.js 没关掉 | 按 Ctrl+C 结束旧进程,或把 app.listen(3000, …) 改成别的端口 | |
| 页面能打开,点「提交查询」后底部没有推荐结果 | index.jade 里 input 的 name 与 index.js 里读的 req.body 字段不一致,或 Spark 作业本身报错 | 逐项核对字段名;再看 spark_submit.stdout 与终端输出里的报错信息 |