Node.js 的安装和使用方法
6.1 这是什么
本章解决的是「算出来的结果怎么送到浏览器里」这件事。前面几章用 Hadoop、Spark 把数据算出来,结果停在终端或文件里;本章装上 Node.js,把结果包装成网页,让浏览器直接访问。完成本章后机器上会有三样可用的东西:一个监听 3000 端口的最小 HTTP 服务、一个能注册和登录的用户站点、一个在网页上提交文件路径就能看到词频统计结果的页面。
Node.js 是让 JavaScript 跑在服务端的运行时环境。JavaScript 原本只能写在网页里由浏览器执行,Node.js 把同一套语言搬到服务器上,让它能读写文件、开网络端口、连数据库,于是前后端可以用一种语言写。npm 是 Node.js 自带的包管理器,用 npm install 包名 就能把别人写好的包下载到当前项目目录,依赖关系由 npm 自动处理;package.json 是项目的说明书,记录名称、入口文件和依赖了哪些包及版本,npm init 生成它,之后每装一个包都会被自动更新。
Express 是 Node.js 里最常用的 Web 框架。只用 Node 自带的 http 模块也能写网站,但每个请求都要手工判断路径和方法;Express 把这件事变成注册路由,写一行 app.get('/', 处理函数) 就表示「谁访问根路径就交给这个函数」。Jade 是模板引擎(新版本改名叫 Pug),负责把数据拼成 HTML,用缩进代替成对标签,#{message} 表示把变量填进页面,服务端用 res.render('index', {...}) 渲染出最终网页。body-parser 是一段中间件,专门把前端用 POST 提交的表单数据解析成 req.body。
回调与异步是理解本章代码的关键:发起网络请求、数据库查询或外部命令时,函数不会停在那里等结果,而是等结果回来后再调用事先传进去的那个函数,代码里的 function (err, rs) { ... } 就是回调。MapReduce 是 Hadoop 的分布式计算模型,Map 把每条记录变成键值对,Reduce 按键归并,词频统计是它的经典例子:Map 把每行切成单词并记为 (单词, 1),Reduce 把同一个单词的计数累加,6.3.5 节把这件事接到网页上。本章处在网页层的位置,向前依赖第 1 章装好的 Hadoop、Spark、Maven 和 MySQL,向后供第 7、8 章的电影推荐系统使用,把 Spark 算出的结果展示到浏览器里。
6.2 前置条件
动手前逐条核对下面这些。
- Ubuntu 虚拟机已能正常登录并联网,
ping -c 3 www.baidu.com有回包,npm install才拉得到包;当前用户在~下有写权限,用whoami和pwd确认。 - JDK 已安装,
java -version能打印版本号,6.3.5 节的打包与作业提交要用它。 - Hadoop 已启动,
jps输出里能看到NameNode、DataNode、SecondaryNameNode;Spark 已安装,/usr/local/spark/bin/spark-submit --version能打印版本号。 - Maven 已安装,
mvn -v能看到版本号和MAVEN_HOME;MySQL 已启动,service mysql status出现active (running),mysql -uroot -p能进入mysql>提示符。 - HDFS 上有待统计的文本文件,例如
hdfs://localhost:9000/user/hadoop/word.txt,本地也留一份/home/hadoop/word.txt;3000 端口空闲(netstat -tlnp | grep 3000无输出)。
6.3 操作步骤
6.3.1 安装 Node.js 与 npm
这一步把 Node.js 解压到 /usr/local 并配置环境变量,让 node 和 npm 在任何目录下都能用。下面以 node-v14.21.3-linux-x64.tar.xz 为例,压缩包放在 ~/Downloads,解压后移动到 /usr/local/node。
# 执行目录:~/Downloads
uname -m
tar -xvf node-v14.21.3-linux-x64.tar.xz
sudo mv node-v14.21.3-linux-x64 /usr/local/node接着写环境变量。NODE_HOME 指向解压出来的目录,在 ~/.bashrc 末尾追加 export NODE_HOME=/usr/local/node 和 export PATH=$NODE_HOME/bin:$PATH 两行,PATH 里就带上了它的 bin 子目录,命令才找得到;保存后用 source 让配置生效,再验证版本。
# 执行目录:~
vim ~/.bashrc
source ~/.bashrc
node -v
npm -v
两条命令各自打印一个版本号,说明安装成功:
v14.21.3
6.14.18
容易踩的地方:只写环境变量不执行 source ~/.bashrc,当前终端仍然找不到 node,需要新开一个终端或手动加载。
6.3.2 创建 Node.js 应用
创建 Node.js 应用包括三个基本步骤:引入 Node.js 模块、创建服务器、接收请求与响应请求。先建项目目录,约定所有 Node.js 项目都放在 ~/nodejsAPP 下。
# 执行目录:~
mkdir -p ~/nodejsAPP/mynodeapp
cd ~/nodejsAPP/mynodeapp
引入模块靠 require 指令。Node.js 用模块划分功能,require('http') 把 HTTP 模块装载进来并赋给变量 http,这个变量就带着和 HTTP 相关的全部函数;在 ~/nodejsAPP/mynodeapp 下执行 vim server.js 新建文件后,写入下面的代码。http.createServer() 创建服务器,括号里的函数每来一个请求就被调用一次,request 是进来的请求,response 是要发回去的响应;writeHead(200, ...) 发送状态码 200 和内容类型,listen(3000) 绑定 3000 端口。
// 文件:~/nodejsAPP/mynodeapp/server.js
var http = require('http');

http.createServer(function (request, response) {
    response.writeHead(200, {'Content-Type': 'text/plain'});
    response.end('Hello World\n');
}).listen(3000);

console.log('Server running http://127.0.0.1:3000/');
保存退出后用 node 运行。
# 执行目录:~/nodejsAPP/mynodeapp
node server.js
终端出现下面这行,表示服务器已经在监听:
Server running http://127.0.0.1:3000/在浏览器地址栏输入 http://127.0.0.1:3000/ 或 http://localhost:3000/,页面上显示 Hello World。
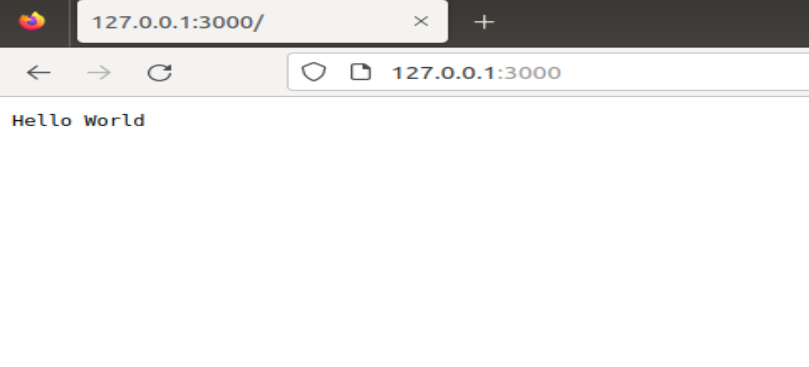
容易踩的地方:运行 node server.js 的终端窗口不能关,一关服务器就停;要结束服务器按 Ctrl+C。如果提示 listen EADDRINUSE,说明 3000 端口已被占用,把代码里的 3000 改成 3001 再试。
6.3.3 案例 1:使用 Express 框架和 Jade 模板引擎
这一小节把裸 http 模块换成 Express,再让 Jade 负责生成 HTML,为下一节的注册登录页面打底。先建项目并初始化,npm init 会连续提问,一路按回车接受默认值,最后输入 yes 确认,项目根目录下就多出一个 package.json。
# 执行目录:~/nodejsAPP
mkdir expressapp
cd expressapp
npm init
npm install express --save
npm install jade --save
--save 前面是两个英文短横线,作用是把新装的包写进 package.json 的依赖列表;装完后项目根目录下会多出 node_modules 文件夹,下载下来的包都堆在里面,Node.js 引用模块时会自动到这里找,不需要写完整路径。
指定模板引擎和模板目录,再注册一条路由。app.set('view engine', 'jade') 告诉 Express 用 Jade 解析模板;app.set('views', __dirname) 表示模板文件就放在入口文件所在目录。
// 文件:~/nodejsAPP/expressapp/app.js
var express = require('express');
var app = express();

app.set('view engine', 'jade');
app.set('views', __dirname);

app.get('/', function (req, res) {
    res.render('index', {title: 'hello'});
})

app.listen(3000, function () {
    console.log('express server start......');
})
同目录下新建 index.jade。Jade 用缩进表示层级,!= 后面接变量,标签的属性写在括号里。
// 文件:~/nodejsAPP/expressapp/index.jade
html
    head
        title!= title
    body
        h1 Jade 模板渲染成功
        p 这一行文字由模板生成
保存后启动服务,浏览器访问 http://127.0.0.1:3000 就能看到模板渲染出来的页面。
# 执行目录:~/nodejsAPP/expressapp
node app.js容易踩的地方:模板文件和入口文件不在同一层时,app.set('views', __dirname) 要改成模板实际所在目录,否则报 Failed to lookup view "index"。
6.3.4 案例 2:采用 Jade 模板引擎实现用户注册登录功能
这一小节做完整的注册登录站点,用户名和密码保存在 MySQL 数据库里,按课程给的八步走:创建 MySQL 数据库、创建项目目录、安装 Express、安装 Jade、安装 MySQL 驱动、创建服务器、创建网页、测试网页。
第一步,创建 MySQL 数据库。-u 后面跟用户名,-p 表示回车后会提示输入密码。
# 执行目录:任意目录下均可执行
mysql -u root -p
进入 mysql> 提示符后依次建库、建表、查看表结构。
-- 在 mysql> 提示符下逐条执行
create database userlogin;
use userlogin;
create table user (userid int(20) not null auto_increment, username char(50), password char(50), primary key(userid));
desc user;
userid 设为 auto_increment,插入记录时不用手工指定编号,数据库自动递增;primary key(userid) 把它设成主键,保证每条用户记录有唯一标识。
第二步到第六步,创建项目目录并初始化,然后装四个包:Express 提供 Web 框架,Jade 提供模板,mysql 是数据库驱动,body-parser 负责解析 POST 表单数据。
# 执行目录:~/nodejsAPP
mkdir userloginjadeapp
cd userloginjadeapp
npm init
npm install express --save
npm install jade --save
npm install mysql --save
npm install body-parser --save
第七步,创建服务器。在项目目录下新建 userloginjade.js,它是整个应用的入口。app.use() 是 Express 调用中间件的核心函数,把 body-parser 挂上去以后,所有请求都会先经过它解析表单数据;数据库连接部分的密码要改成自己机器上的。
// 文件:~/nodejsAPP/userloginjadeapp/userloginjade.js
var express = require('express');
var bodyParser = require('body-parser')
var app = express();
var mysql = require('mysql');
app.set('view engine', 'jade');
app.set('views', __dirname);
app.use(bodyParser.urlencoded({extended: false}))
app.use(bodyParser.json())

// 配置 MySQL,password 换成自己机器上的密码
var connection = mysql.createConnection({
    host: '127.0.0.1',
    user: 'root',
    password: '123456',
    database: 'userlogin',
    port: '3306'
});
connection.connect();

// 跳转到网站首页,也就是用户登录页面
app.get('/', function (req, res) {
    res.render('index', {title: 'hello'});
})

// 实现登录验证功能
app.post('/login', function (req, res) {
    var name = req.body.username.trim();
    var pwd = req.body.pwd.trim();
    var selectSQL = "select * from user where username = '" + name + "' and password = '" + pwd + "'";
    connection.query(selectSQL, function (err, rs) {
        if (err) throw err;
        if (rs.length == 0) {
            res.render('error', {title: 'WARNING', message: '对不起,用户名:' + name + ' 不存在'});
            return;
        }
        res.render('ok', {title: 'Welcome User', message: name});
    })
})

// 跳转到注册页面
app.get('/registerpage', function (req, res) {
    res.render('registerpage', {title: '注册'});
})

// 实现注册功能,insert into user set ? 由驱动替换成 username 和 password 两个字段
app.post('/register', function (req, res) {
    var name = req.body.username.trim();
    var pwd = req.body.pwd.trim();
    var user = {username: name, password: pwd};
    connection.query('insert into user set ?', user, function (err, rs) {
        if (err) throw err;
        res.render('ok', {title: 'Welcome User', message: name});
    })
})

var server = app.listen(3000, function () {
    console.log("userloginjade server start......");
})
connection.query 的第二个参数是回调,数据库把结果交回来时才会执行,所以密码比对和页面渲染都写在回调里面,不能写到 query 后面。
注册登录一次完整数据流如下。
第八步,创建四个模板文件。它们和上一节一样以 html、head(内含 title!= title)、body 为骨架,下面只列 body 主体。输入框靠 name 属性取名,服务端就是按这两个名字取值的。
// 文件:~/nodejsAPP/userloginjadeapp/index.jade
form(action='/login', method='post')
    p 用户登录
    p User Name:
    input(type='text', name='username')
    p Password:
    input(type='text', name='pwd')
    input(type='submit', value='登录')
    a(href='/registerpage', title='注册') 注册
registerpage.jade 与登录页结构相同,只是提交地址换成 /register,标题和按钮文字换成「注册」。
// 文件:~/nodejsAPP/userloginjadeapp/registerpage.jade
form(action='/register', method='post')
    p 用户注册
    p User Name:
    input(type='text', name='username')
    p Password:
    input(type='text', name='pwd')
    input(type='submit', value='注册')
ok.jade 和 error.jade 都只负责把 message 显示出来,区别在提示语。
// 文件:~/nodejsAPP/userloginjadeapp/ok.jade
h1 热烈欢迎用户: #{message}
// 文件:~/nodejsAPP/userloginjadeapp/error.jade
h1 #{message}测试网页。启动服务器,然后在浏览器访问 http://localhost:3000。
# 执行目录:~/nodejsAPP/userloginjadeapp
node userloginjade.js
终端打印启动信息:
userloginjade server start......默认看到的是登录页,页面底部有跳转到注册页的链接。
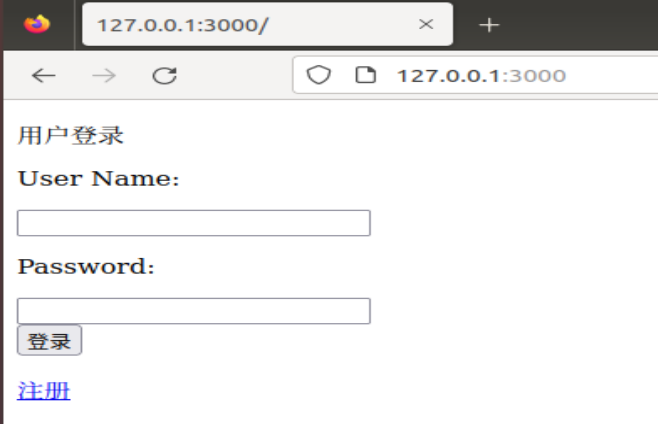
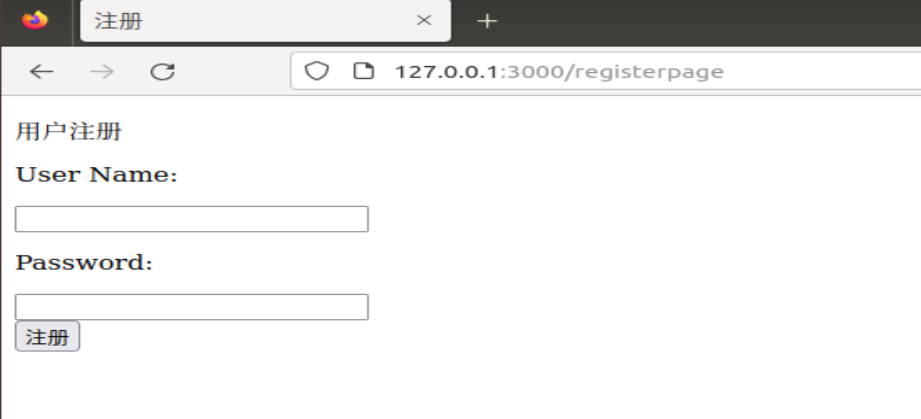
点「注册」进入注册页,填入用户名和密码后提交。
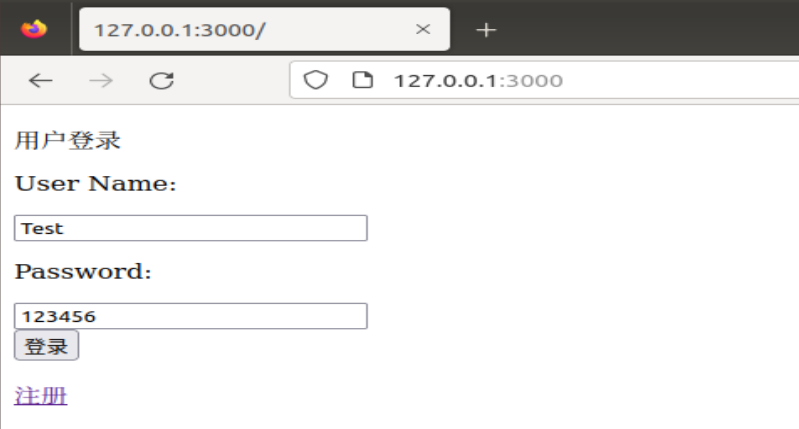
回到 http://localhost:3000,用教程里的样例账号 Test 和密码 123456 走一遍同样的流程,登录表单填好后的样子如下。
容易踩的地方:登录查询是直接把变量拼进 SQL 字符串的,用户名里带英文单引号会让语句出错;数据库密码写在代码里,换成自己机器的密码才能连上,连不上时会直接抛 Error: ER_ACCESS_DENIED_ERROR。
6.3.5 案例 3:通过网页调用词频统计应用程序
这一小节先打包一个词频统计程序,再写网页去调用它:页面提交文件路径,后端执行 spark-submit 跑作业,把结果读回来显示。先建 Scala 项目骨架,Maven 只认 src/main/scala 这个标准结构。
# 执行目录:~/nodejsAPP
mkdir -p WordCount/src/main/scala
cd WordCount/src/main/scala
vim WordCount.scala
新建的 WordCount.scala 里,args(0) 是输入文件路径,args(1) 是输出路径;flatMap 把每行按空格切成单词,map 给每个单词记 1,reduceByKey 把同一个单词的计数加起来,这就是 MapReduce 在 Spark 里的写法。
// 文件:~/nodejsAPP/WordCount/src/main/scala/WordCount.scala
import org.apache.spark.SparkContext
import org.apache.spark.SparkContext._
import org.apache.spark.SparkConf

object WordCount {
    def main(args: Array[String]) {
        val inputFile = args(0)          // 第1个参数是输入文件路径
        val conf = new SparkConf().setAppName("WordCount").setMaster("local")
        val sc = new SparkContext(conf)
        val textFile = sc.textFile(inputFile)
        val wordCount = textFile.flatMap(line => line.split(" ")).map(word => (word, 1)).reduceByKey((a, b) => a + b)
        wordCount.foreach(println)
        wordCount.saveAsTextFile(args(1))   // 第2个参数是输出文件路径
    }
}
回到 WordCount 目录创建 pom.xml,可以直接复制第 7.3.4 节的 pom 代码,把 artifactId 改成 WordCount:装 Spark 2.4.0 的用对应旧版 pom,装 Spark 3 以上版本的用新版 pom。执行 find . 应当能看到 ./src/main/scala/WordCount.scala 和 ./pom.xml。
# 执行目录:~/nodejsAPP/WordCount
vim pom.xml
find .
mvn package
在当前目录打包。首次运行会联网下载依赖,需要等几分钟。
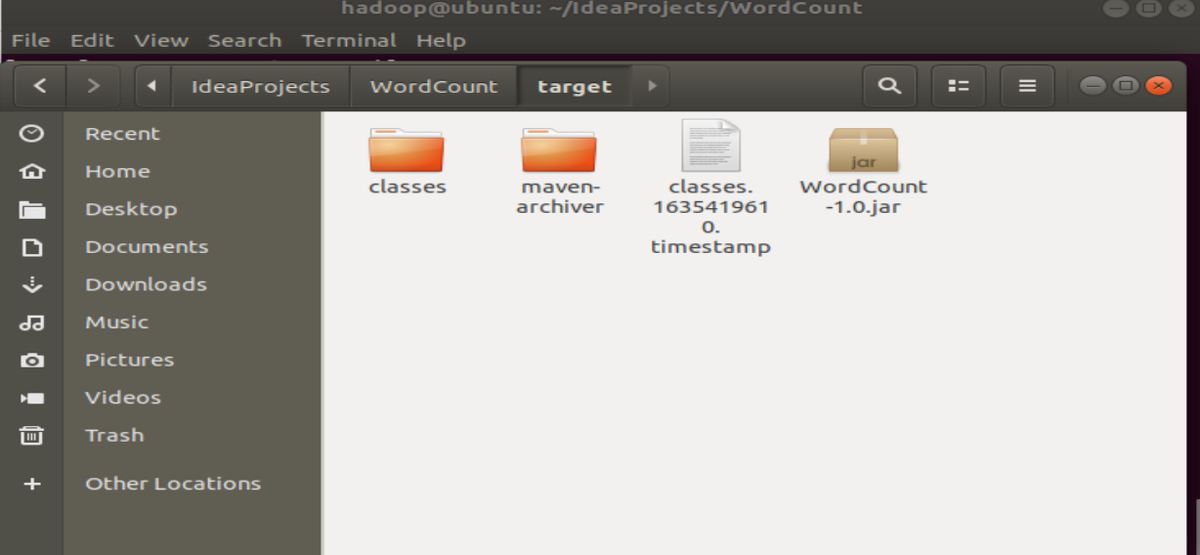
如果提示 mvn not found,先在 ~/.bashrc 末尾补上 export MAVEN_HOME=/usr/local/maven 和 export PATH=$MAVEN_HOME/bin:$PATH,再 source ~/.bashrc。打包成功后目录下会生成 target 文件夹,里面的 WordCount-1.0.jar 就是要被网页调用的程序包。
接着写网页应用,新建项目并初始化。npm init 的全部提问都可以直接回车接受默认值,终端会显示即将写入的 package.json 内容,最后输入 yes 确认。
# 执行目录:~/nodejsAPP
mkdir WordCountApp
cd WordCountApp
npm init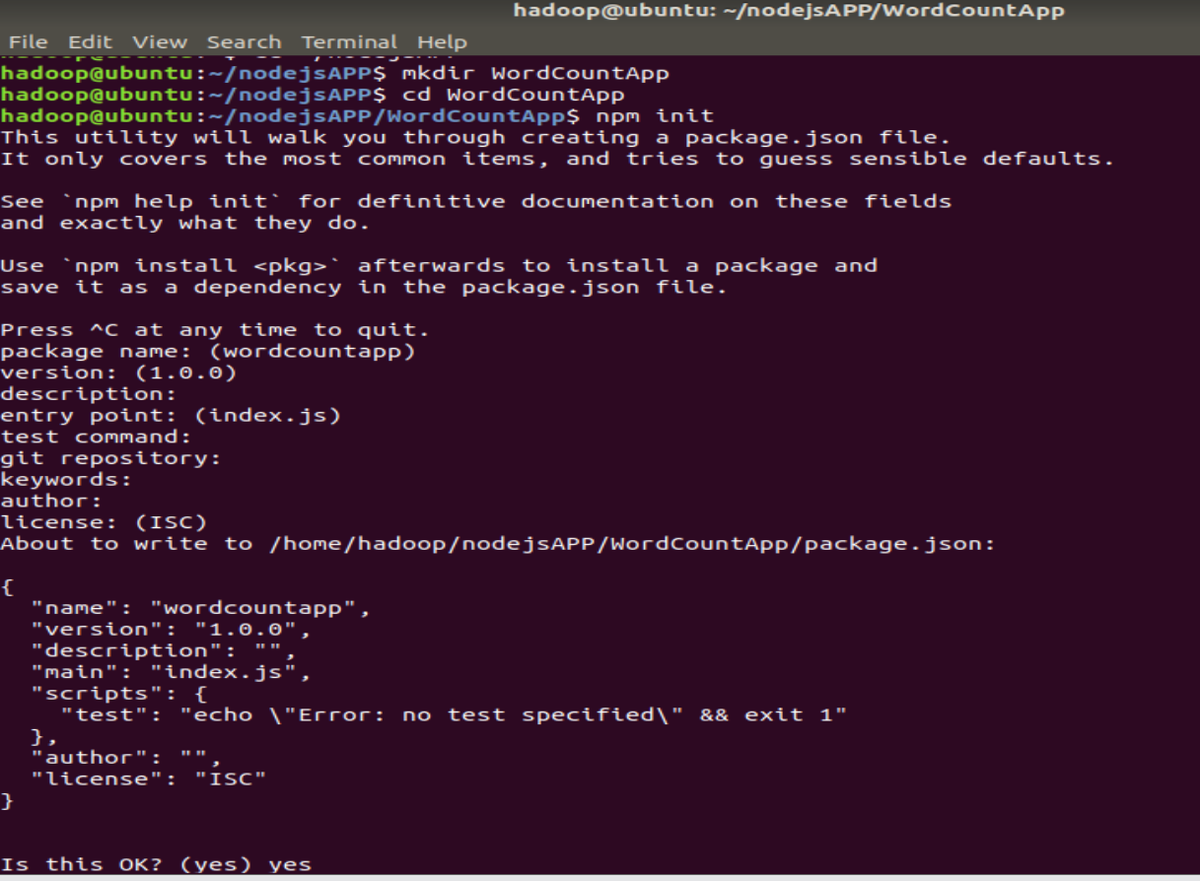
安装 Express 和 Jade。
# 执行目录:~/nodejsAPP/WordCountApp
npm install express --save
npm install jade --save
在项目下新建 views 目录和 views/index.jade。表单提交到根路径,textarea 用来承载统计结果,result 变量一开始是空的,提交后才被填上。
# 执行目录:~/nodejsAPP/WordCountApp
mkdir views
cd views
vim index.jade
// 文件:~/nodejsAPP/WordCountApp/views/index.jade
html
head
title!= title
body
h1!= message
form(action='/', method='post')
p 请在下面输入所需要进行词频统计文件的路径
p HDFS文件路径示例:hdfs://localhost:9000/user/hadoop/word.txt
p 本地文件路径示例:file:///home/hadoop/word.txt
br
input(name='path')
input(type='submit')
br
textarea(rows='40', cols='40')!= result回到 WordCountApp 目录新建 index.js。child_process 的 exec 用来在后台执行 shell 命令,jarStr 拼出 spark-submit 命令并带上用户填的路径,作业跑完后再执行 hdfs dfs -cat 把输出读回来塞进页面。
# 执行目录:~/nodejsAPP/WordCountApp
vim index.js
// 文件:~/nodejsAPP/WordCountApp/index.js
const express = require('express')
const bodyParser = require('body-parser')
const exec = require('child_process').exec
const app = express();
app.set('views', './views')
app.set('view engine', 'jade')
app.use(bodyParser.urlencoded({extended: false}))
app.use(bodyParser.json())
app.get('/', function (req, res) {
res.render('index', {title: 'WordCount测试', message: '大数据平台实训'})
})
app.post('/', function (req, res) {
const path = req.body.path.trim()
const jarStr = '/usr/local/spark/bin/spark-submit --class WordCount ~/nodejsAPP/WordCount/target/WordCount-1.0.jar ' + path + ' hdfs://localhost:9000/user/hadoop/output'
const catStr = '/usr/local/hadoop/bin/hdfs dfs -cat hdfs://localhost:9000/user/hadoop/output/*'
exec(jarStr, function (err, stdout, stderr) {
// 执行成功后,显示统计结果
exec(catStr, function (err, stdout, stderr) {
res.render('index', {title: 'WordCount测试', message: '大数据平台实训', result: 'cat' + stdout})
})
})
})
const server = app.listen(3000, function () {
const host = server.address().address;
const port = server.address().port;
console.log('Example app listening at http://%s:%s', host, port);
});整条链路如下。
启动网页服务,浏览器访问 http://localhost:3000,模板被渲染成 HTML;页面标题下方是输入框和提交按钮,下面还给出行路径的写法示例。
# 执行目录:~/nodejsAPP/WordCountApp
node index.js
在输入框填入 HDFS 文件路径 hdfs://localhost:9000/user/hadoop/word.txt,点提交,下方文本框显示出若干行 (单词, 次数);换成 file:///home/hadoop/word.txt 这样的本地路径提交,同样能拿到结果,说明两种输入源都走得通。
容易踩的地方:hdfs://localhost:9000/user/hadoop/output 这个输出目录每次运行前必须不存在,否则作业会以 org.apache.hadoop.mapred.FileAlreadyExistsException 报错,需要先执行 hdfs dfs -rmr 删掉。程序写死了 --class WordCount 和 jar 包路径,改了项目名或打包产物名,这里要同步改。
6.4 结果验证
逐条核对,每条都能明确判定通过或不通过。
node -v与npm -v都打印出版本号,没有出现command not found。- 在
~/nodejsAPP/mynodeapp下执行node server.js,终端出现Server running http://127.0.0.1:3000/;浏览器访问http://127.0.0.1:3000/,正文显示Hello World。 ~/nodejsAPP/userloginjadeapp/node_modules下能同时看到express、jade、mysql、body-parser四个文件夹,package.json的dependencies里出现对应的四个包名。- 在
mysql>里执行desc user;,输出包含userid、username、password三列,userid的Key为PRI、Extra为auto_increment。 - 浏览器访问
http://localhost:3000返回的页面里有「用户登录」四个字和一个跳转到注册页的链接;点链接后地址变为http://localhost:3000/registerpage,出现「用户注册」表单。 - 用
Test/123456提交后页面跳转到欢迎页并显示该用户名,在mysql>里执行select * from user;能查到这一行记录;用不存在的用户名登录时,页面显示error.jade的错误提示,服务端不崩溃退出。 ls -l ~/nodejsAPP/WordCount/target/能看到WordCount-1.0.jar且文件体积不为 0;在~/nodejsAPP/WordCountApp下执行node index.js,终端打印Example app listening at ...,浏览器访问http://localhost:3000出现输入框和提交按钮,分别填入 HDFS 路径与本地路径提交后,页面下方出现的统计结果中每个单词后面跟着一个正整数,代表它在文件中出现的次数。
6.5 常见问题
| 现象 | 原因 | 处理 | |
|---|---|---|---|
node: command not found | PATH 里没有加 Node.js 的 bin 目录,或改了 ~/.bashrc 后没有生效 | 检查 ~/.bashrc 里的 export PATH=$NODE_HOME/bin:$PATH,执行 source ~/.bashrc 或新开终端 | |
Error: listen EADDRINUSE: address already in use :::3000 | 3000 端口已被其它进程占用,或上一个 node 进程还在跑 | 用 `netstat -tlnp \ | grep 3000` 找到进程并结束,或把代码里的端口改成 3001 |
Error: Cannot find module 'express' | 在错误的目录下启动了程序,或者 npm install 没有执行成功 | 确认在项目根目录(有 node_modules 的那一层)执行 node,必要时重新 npm install express --save | |
Error: ER_ACCESS_DENIED_ERROR: Access denied for user 'root'@'localhost' | 代码里 mysql.createConnection 的 password 与本机 root 密码不一致 | 把 userloginjade.js 里的 password 改成实际密码,并确认 MySQL 服务已启动 | |
mvn: command not found | Maven 的环境变量没配置 | 在 ~/.bashrc 追加 export MAVEN_HOME=/usr/local/maven 与 export PATH=$MAVEN_HOME/bin:$PATH,再 source ~/.bashrc | |
org.apache.hadoop.mapred.FileAlreadyExistsException: Output directory ... already exists | 上一次运行留下的输出目录还在,Spark 不允许覆盖 | 先执行 hdfs dfs -rmr hdfs://localhost:9000/user/hadoop/output 再重新提交 |